爬取京东商品数据为例,保存数据库展示
一、Jsoup概述
1.1、简介
jsoup 是一款Java 的HTML解析器,可直接解析某个URL地址、HTML文本内容。它提供了一套非常省力的API,
可通过DOM,CSS以及类似于jQuery的操作方法来取出和操作数据。
1.2、主要功能
1、从一个URL,文件或字符串中解析HTML
2、使用DOM或CSS选择器来查找、取出数据
3、可操作HTML元素、属性、文本
注意:jsoup是基于MIT协议发布的,可放心使用于商业项目。
二.网页分析
2.1搜索参数
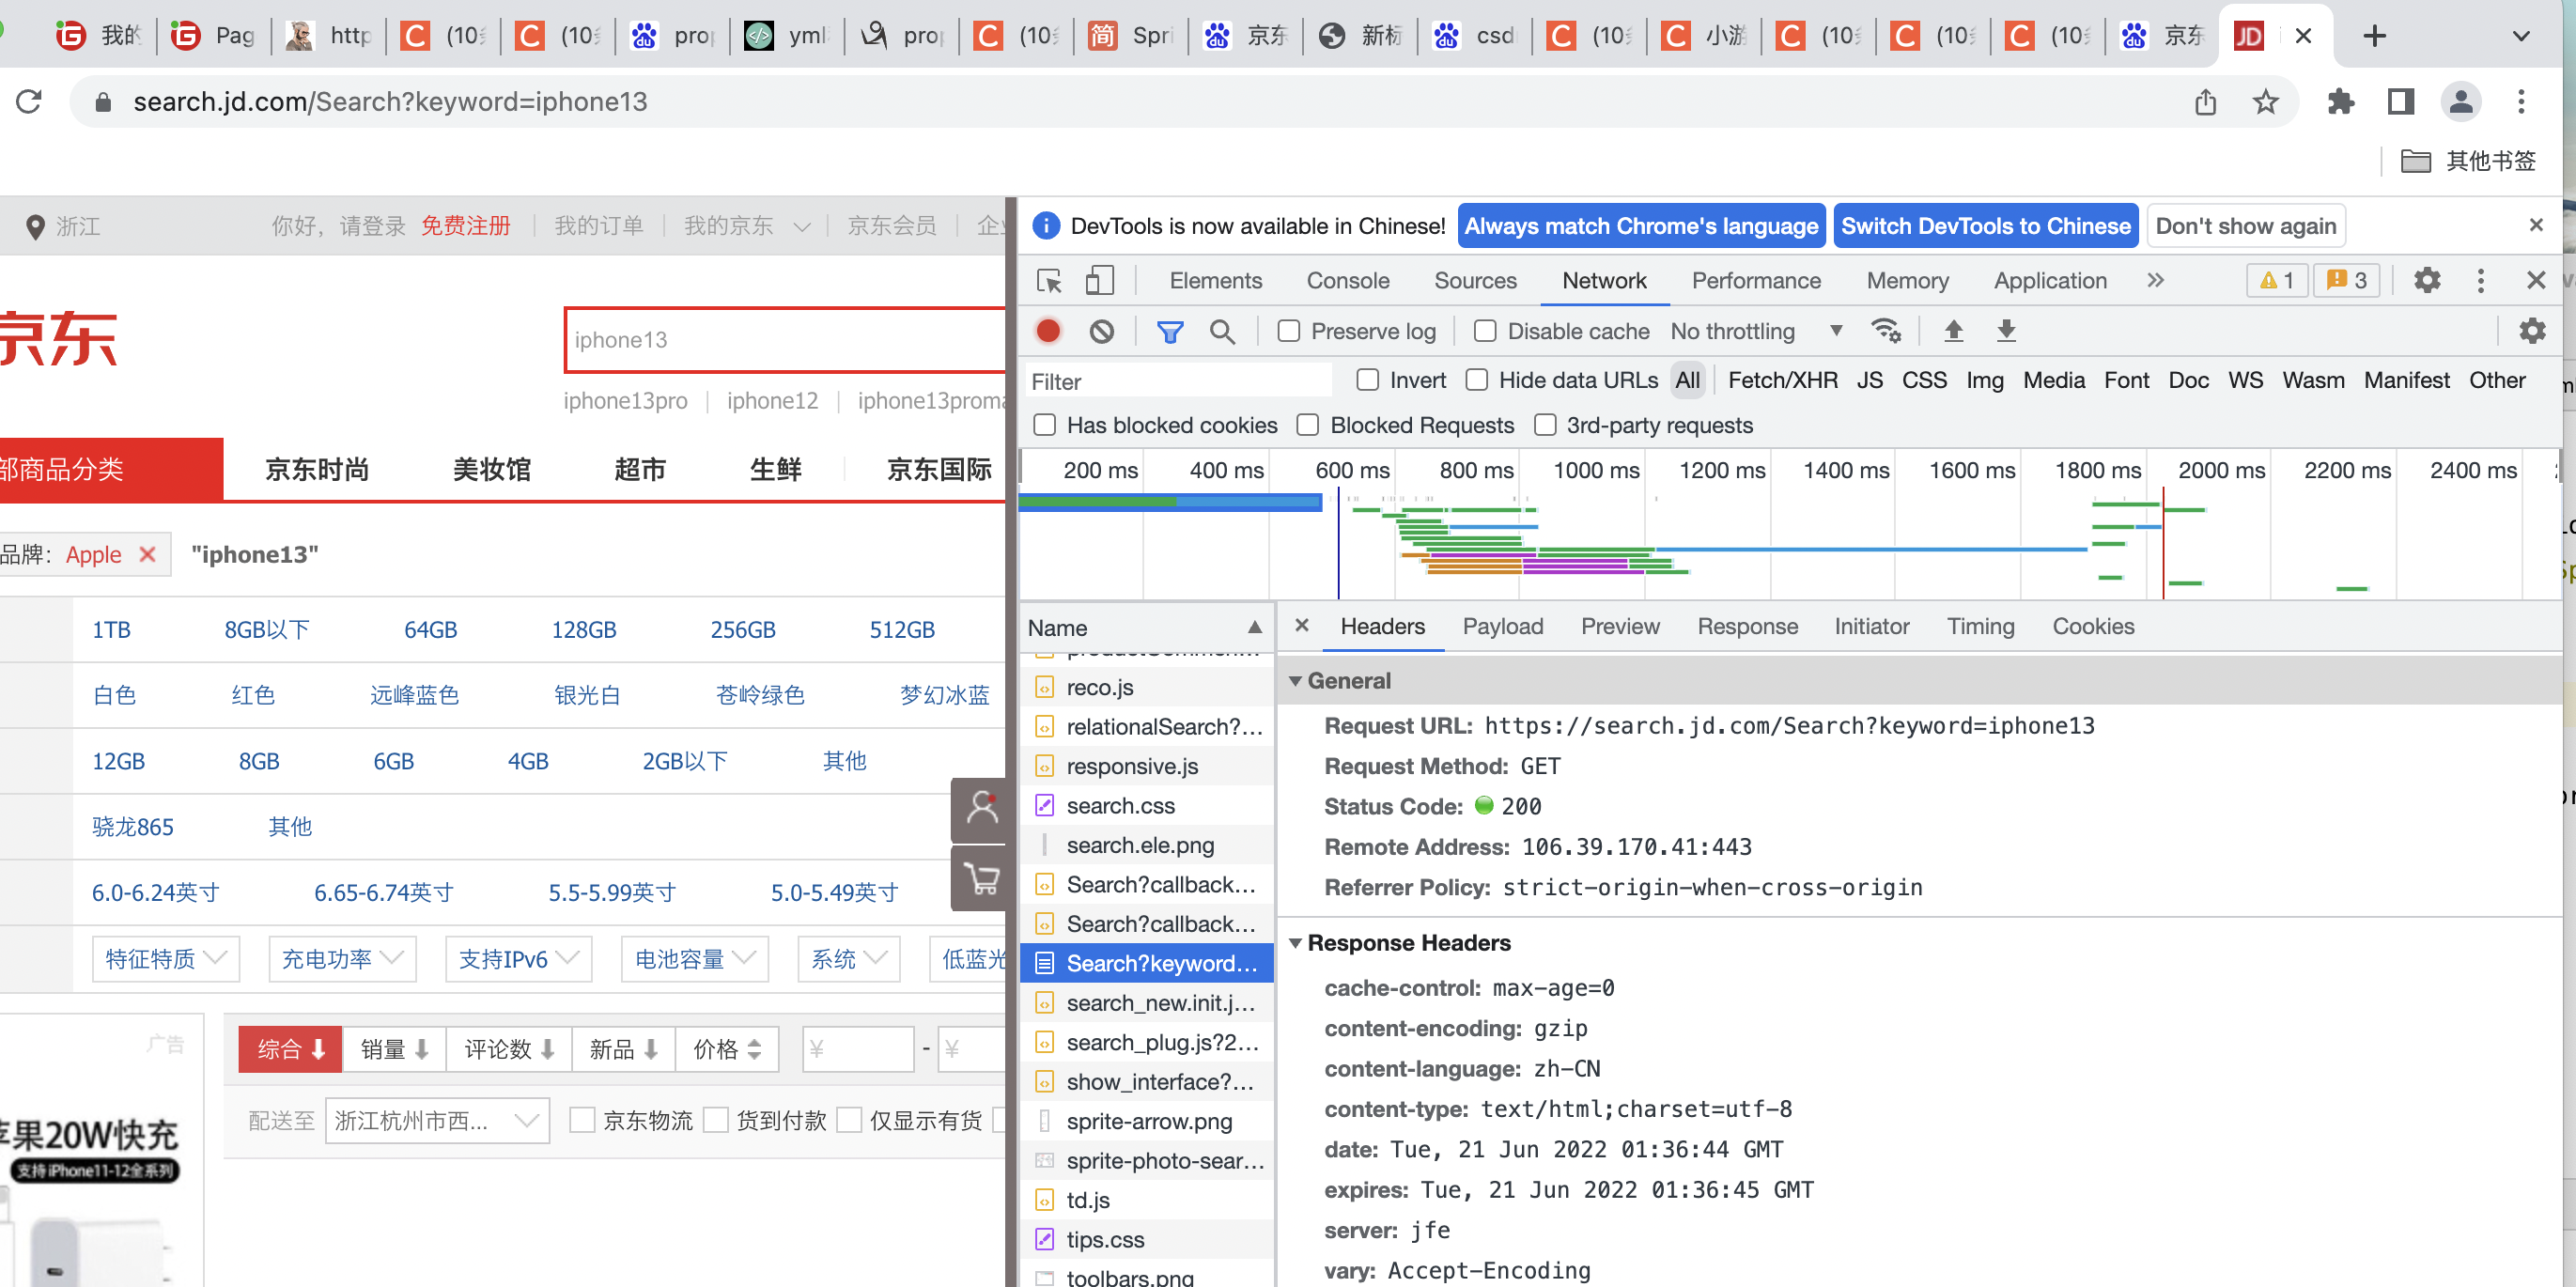
1.首先我们打开京东搜索的网页,通过开发者工具可以发现,输入框的id是keyword。
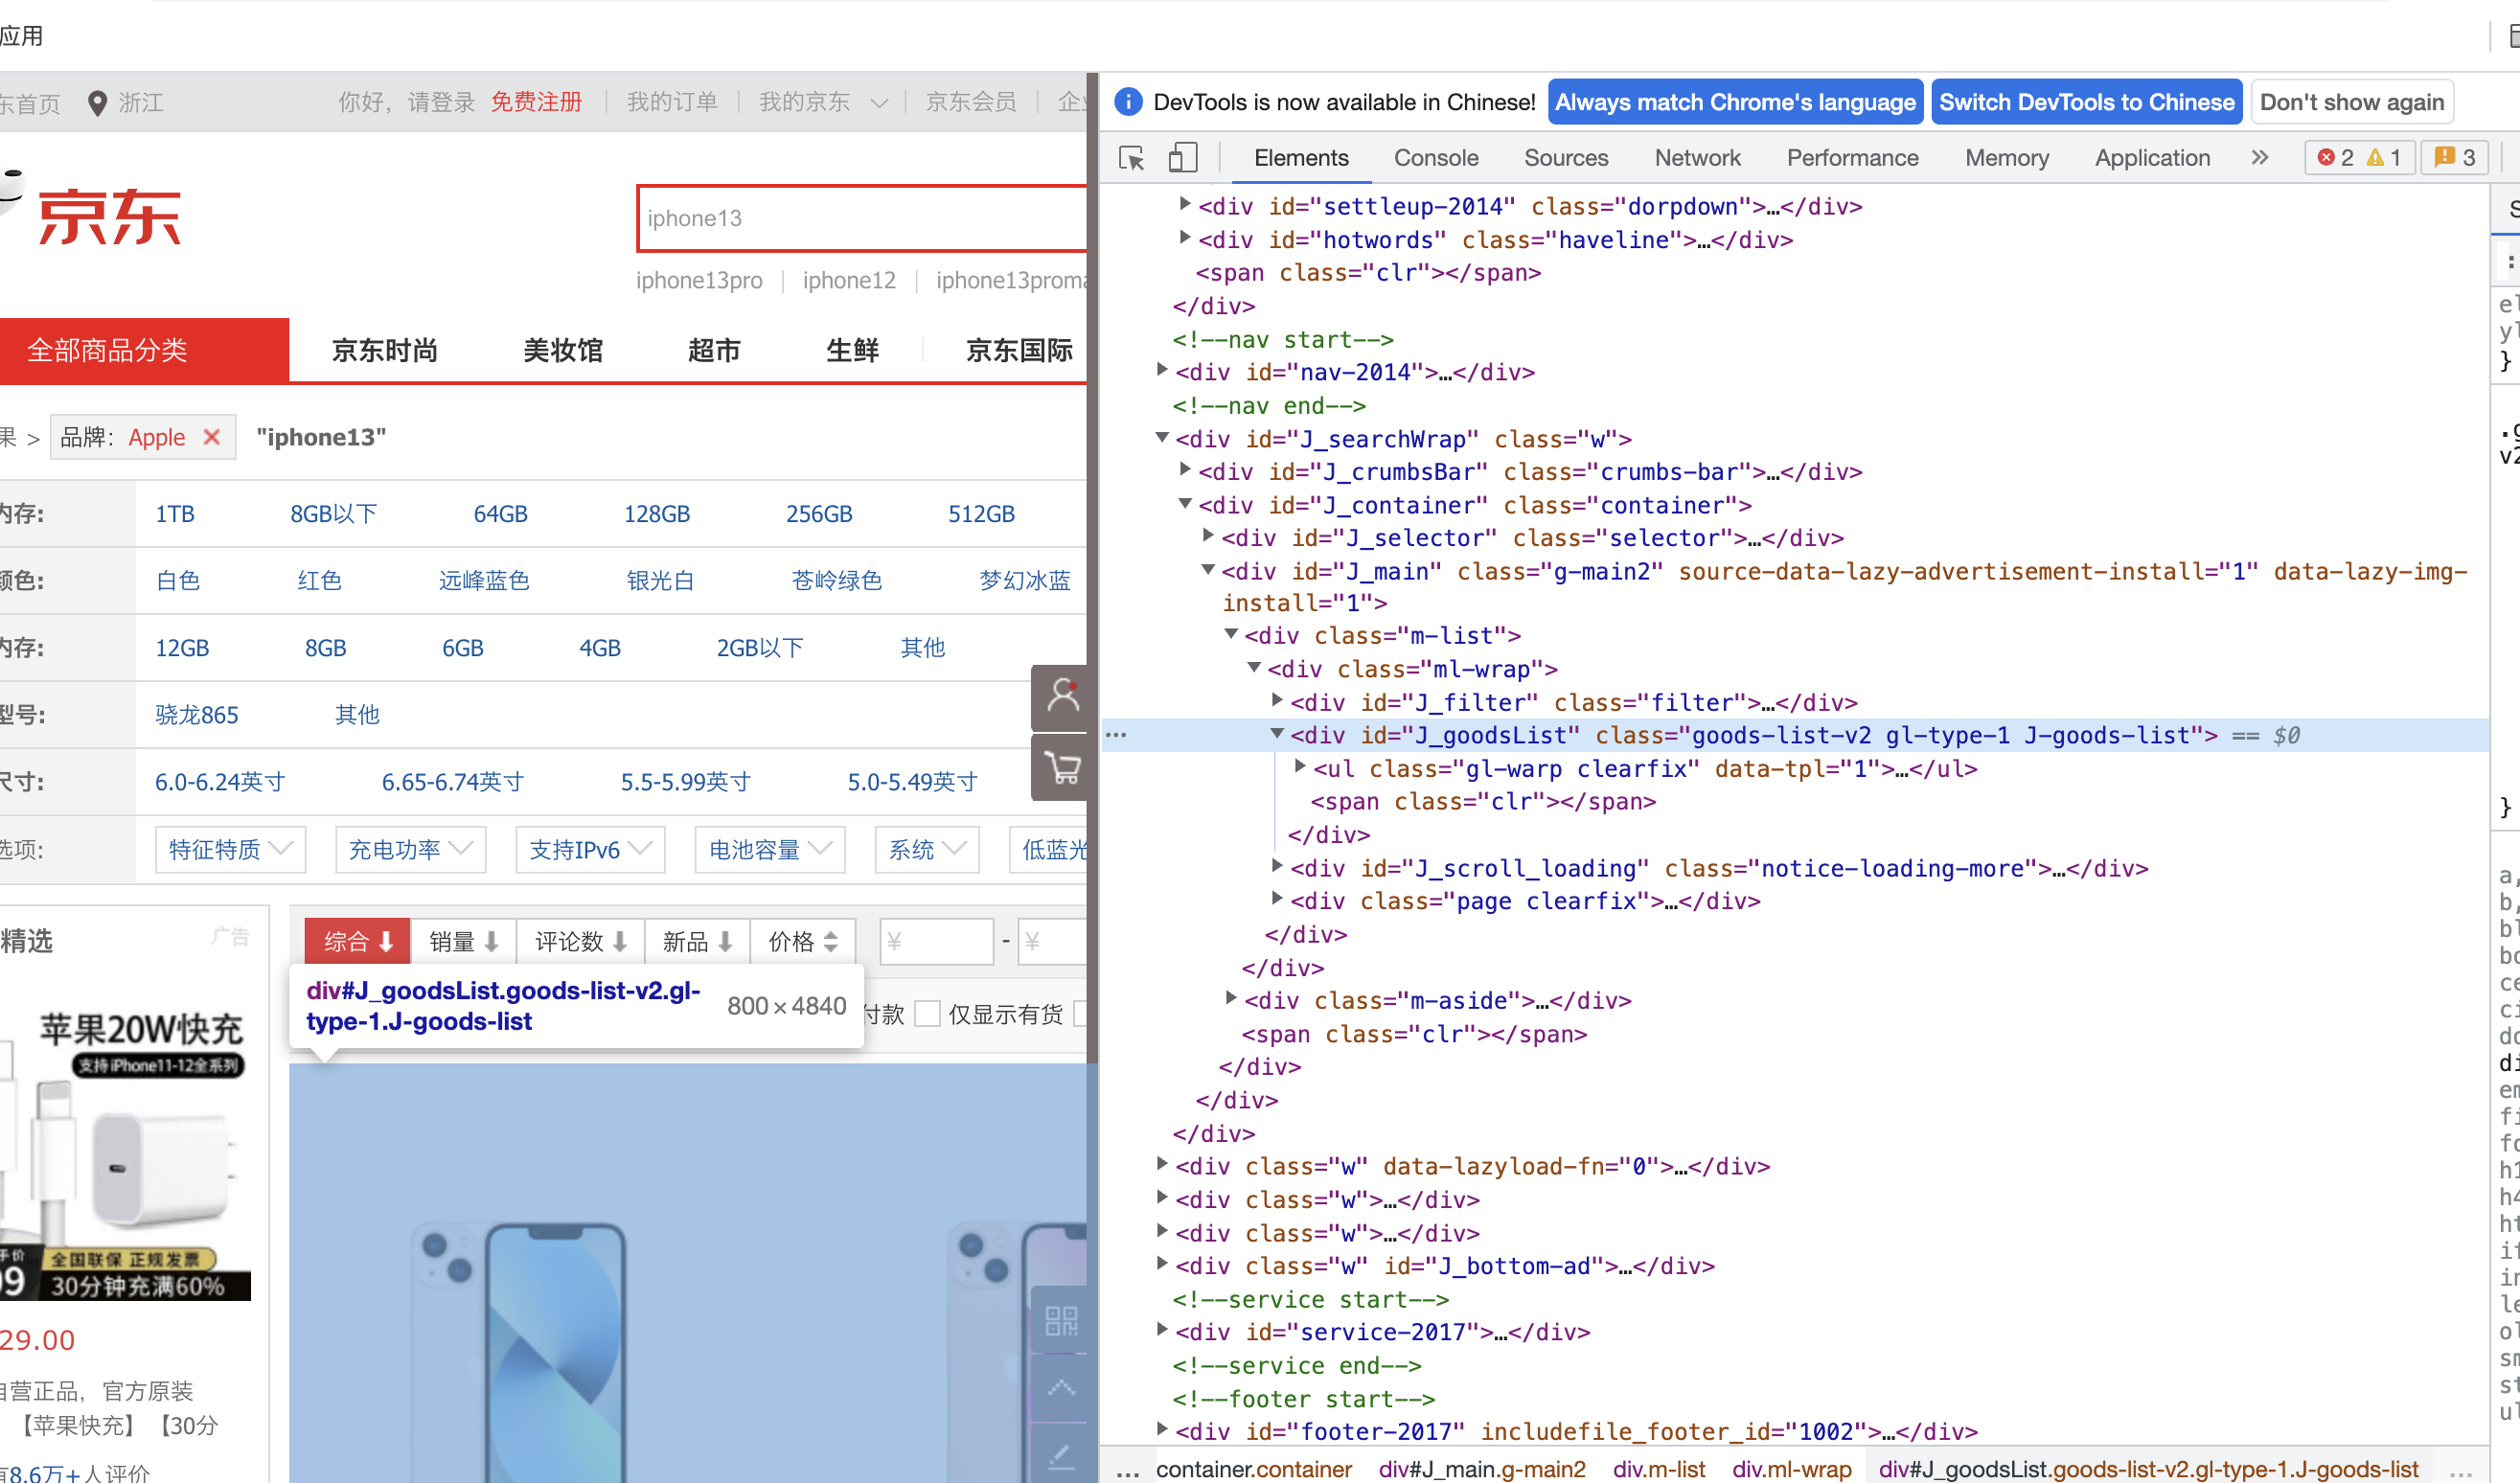
2.随后我们找到整个商品的div,如下图所示,它的id为“J_goodsList”
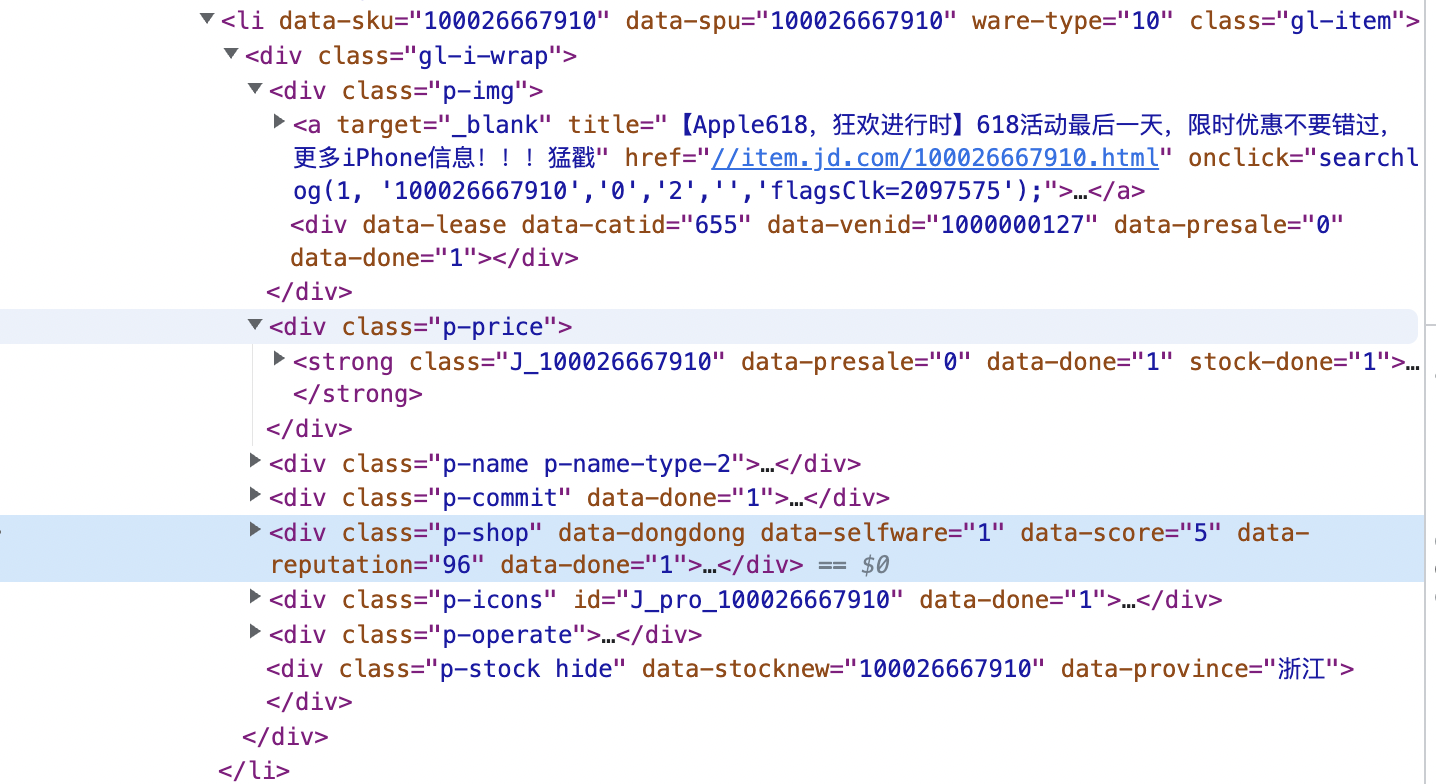
3.分析这个div,就能找到li下面每个手机参数(图片,名称,价格等)
三.数据爬取
1.新建项目,编写数据爬取的utils
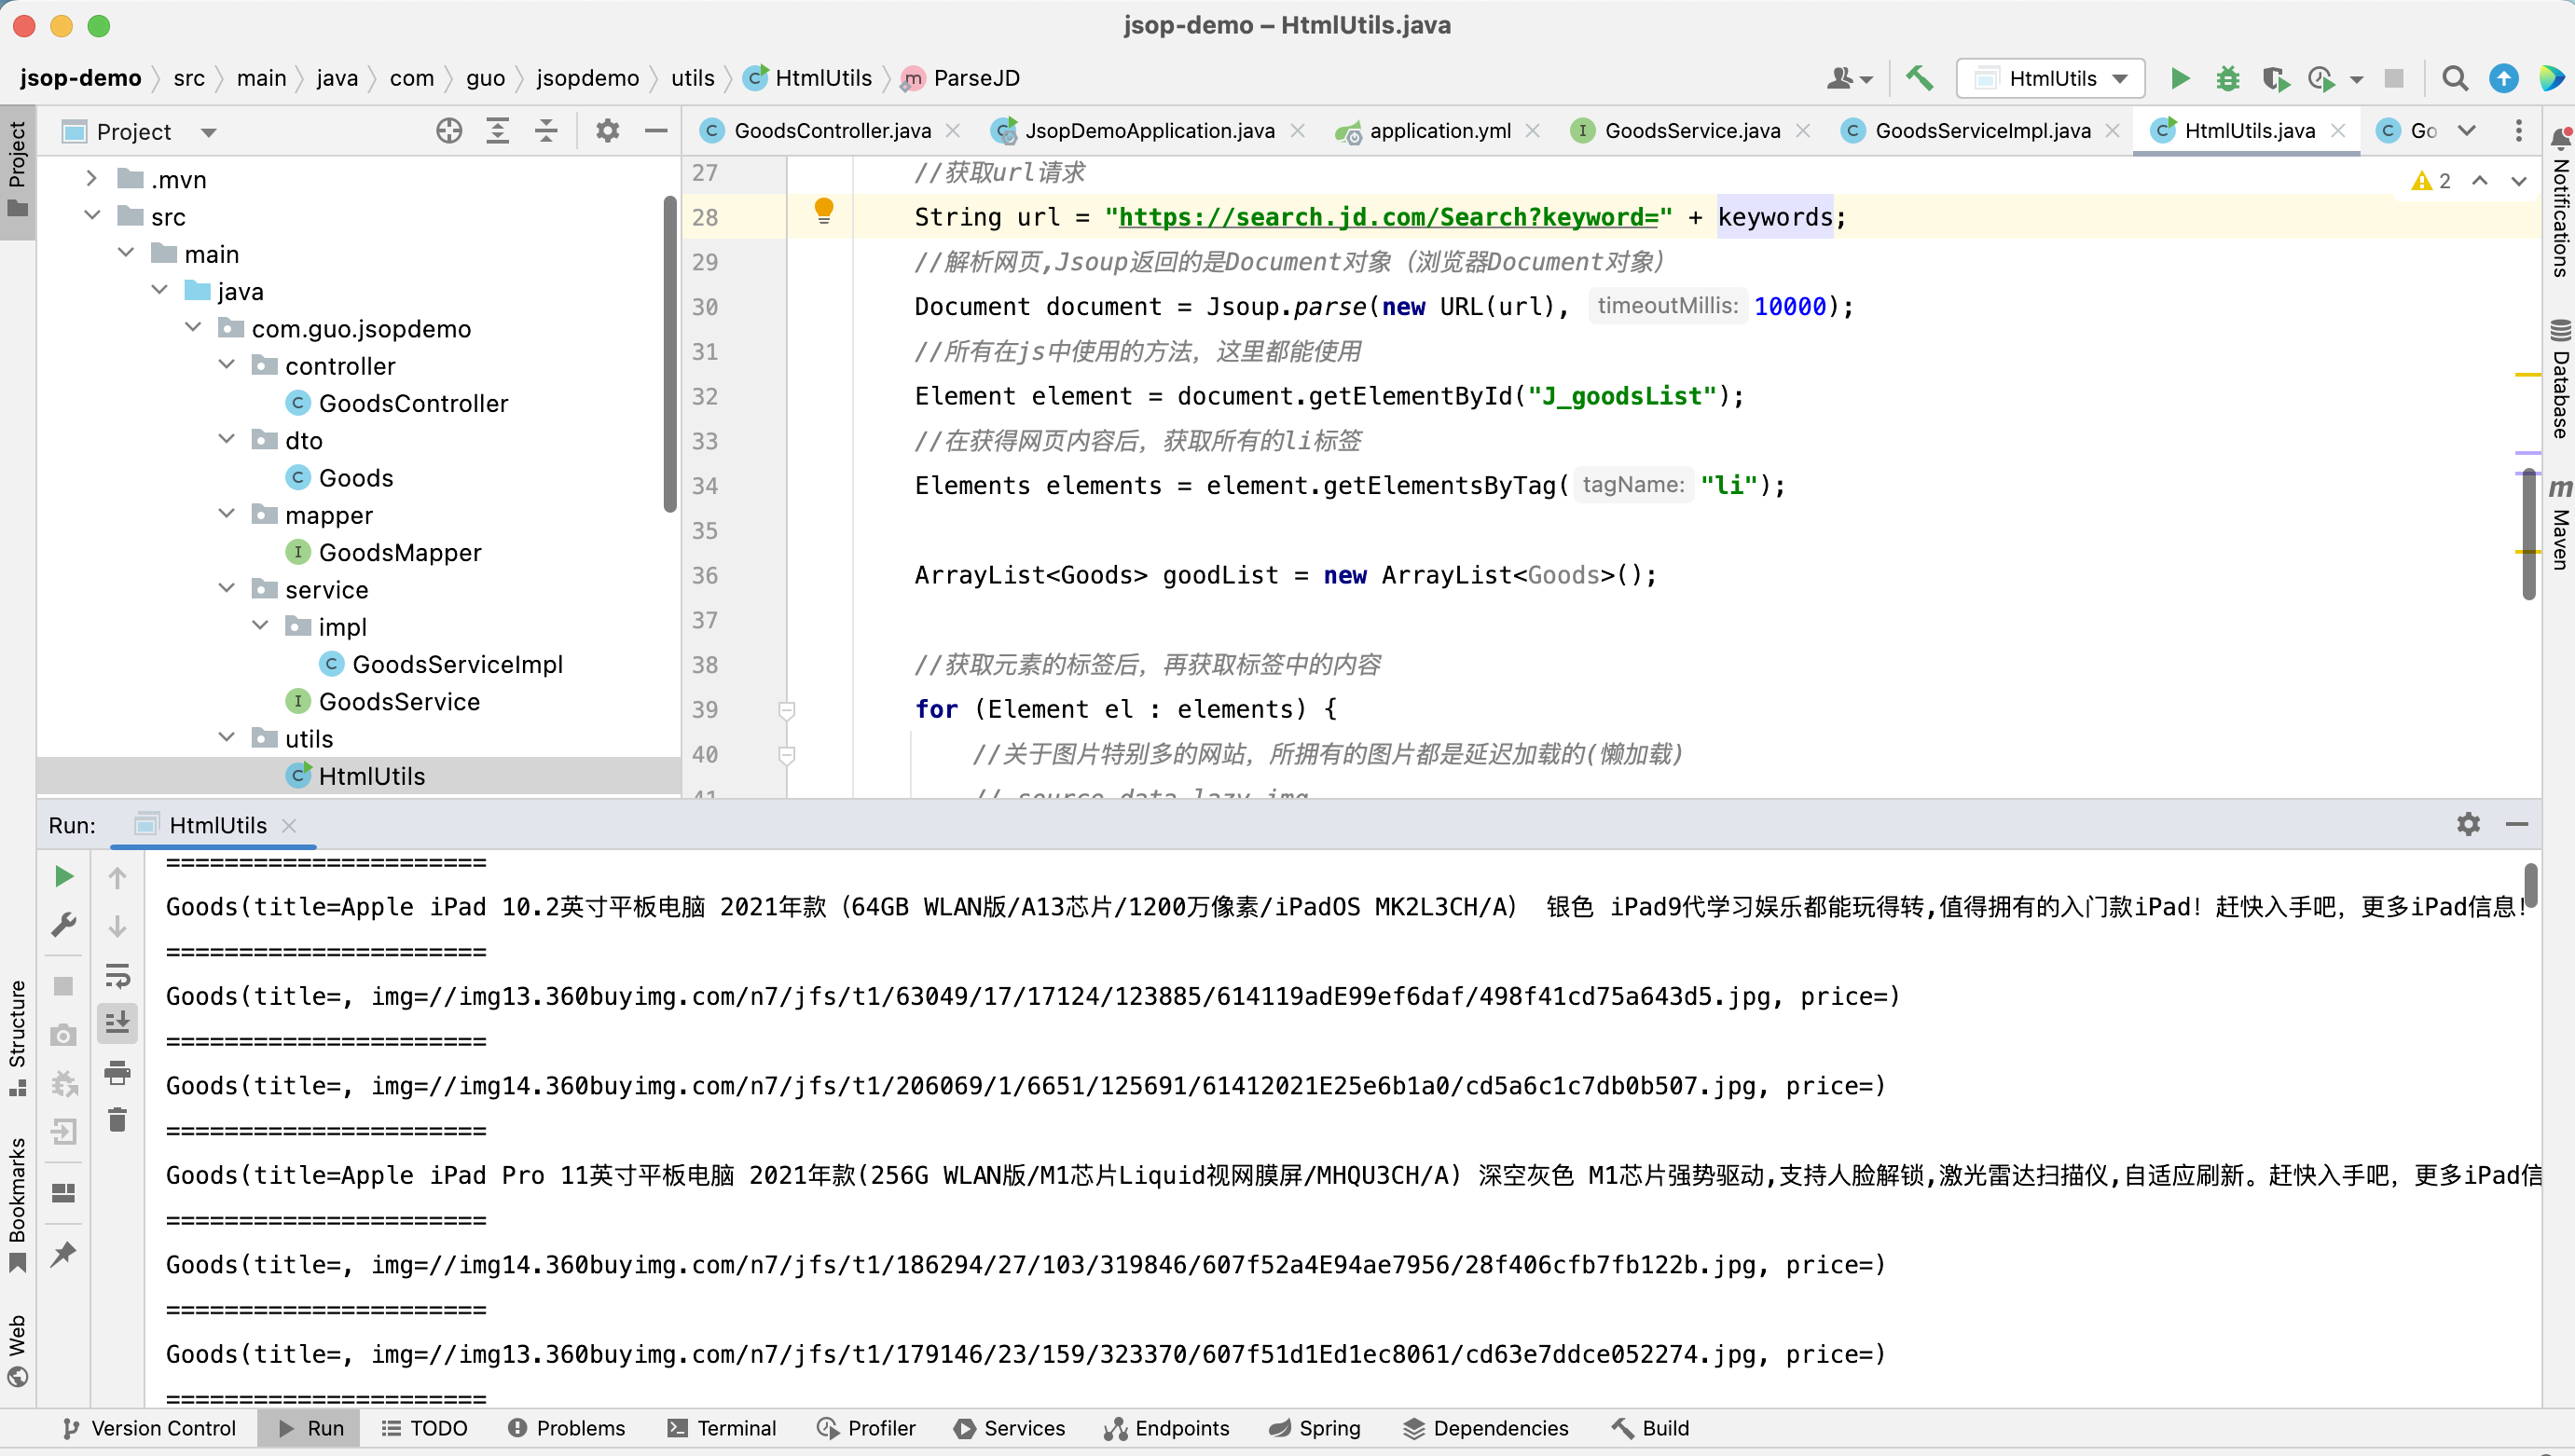
package com.guo.jsopdemo.utils;

import com.guo.jsopdemo.dto.Goods;

import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;
import java.net.URL;
import java.util.ArrayList;
import java.util.List;

public class HtmlUtils {


    public static void main(String[] args) throws Exception {
        //搜索词可以更换,此处以java为例
        List goodList = ParseJD("苹果");
        for (Object o : goodList) {
            System.out.println(o);
            System.out.println("======================");
        }
    }


    public static List<Goods> ParseJD(String keywords) throws Exception {
        //获取url请求
        String url = "https://search.jd.com/Search?keyword=" + keywords;
        //解析网页,Jsoup返回的是Document对象(浏览器Document对象)
        Document document = Jsoup.parse(new URL(url), 10000);
        //所有在js中使用的方法,这里都能使用
        Element element = document.getElementById("J_goodsList");
        //在获得网页内容后,获取所有的li标签
        Elements elements = element.getElementsByTag("li");
        ArrayList<Goods> goodList = new ArrayList<Goods>();

        //获取元素的标签后,再获取标签中的内容
        for (Element el : elements) {
            String skuCode = el.attr("data-sku");
            //关于图片特别多的网站,所拥有的图片都是延迟加载的(懒加载)
            // source-data-lazy-img
//            String img = el.getElementsByTag("img").eq(0).attr("source-data-lazy-img");
            String img = el.getElementsByTag("img").eq(0).attr("data-lazy-img");
            String price = el.getElementsByClass("p-price").eq(0).text();
            String name = el.getElementsByClass("p-name").eq(0).text();
            Goods goods = new Goods();
            goods.setSkuCode(skuCode);
            goods.setType(keywords);
            goods.setTitle(name);
            goods.setImg(img);
            goods.setPrice(price);
            goodList.add(goods);
        }
        return goodList;
    }
}
2.发现只能处理一页面的数据,尝试点击下一页,分析填充分页面参数
一页为30条,页面分页参数为page
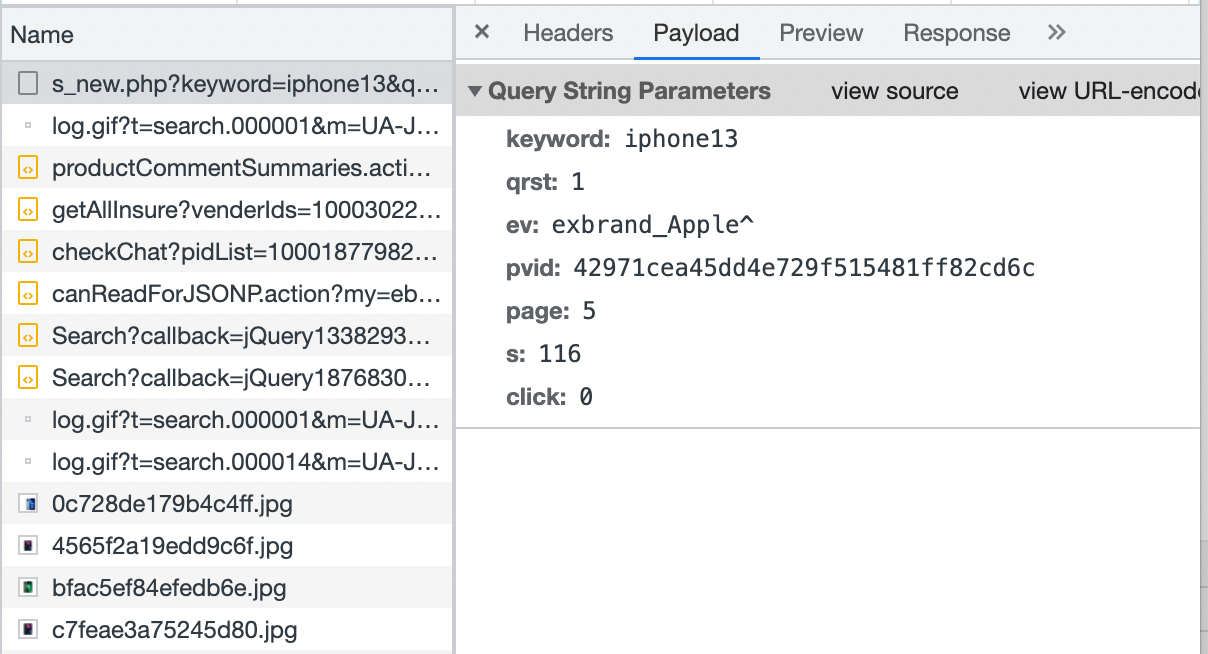
增加分页参数and休眠(图片懒加载,太快图片刷不出来)
package com.guo.jsop.utils;

import com.guo.jsop.dto.Goods;
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;

import java.net.URL;
import java.util.ArrayList;
import java.util.List;

public class HtmlUtils {


    public static void main(String[] args) throws Exception {
        //搜索词可以更换,此处以java为例
        List goodList = parseJD("苹果", 35);
        int i = 0;
        for (Object o : goodList) {
            i++;
            System.out.println("第" + i + "条:" + o.toString());
            System.out.println("======================");
        }
    }


    public static List<Goods> parseJD(String keywords, Integer num) throws Exception {
        //计算分页
        //最大取整
        int page = (int) Math.ceil(num / 30) + 1;
        ArrayList<Goods> goodList = new ArrayList<Goods>();
        for (int j = 1; j <= page; j++) {
            //获取url请求
            String url = "https://search.jd.com/Search?keyword=" + keywords + "&page=" + page;
            //睡眠1s 给懒加载的图片一点时间
            Thread.sleep(1000);
            //解析网页,Jsoup返回的是Document对象(浏览器Document对象)
            Document document = Jsoup.parse(new URL(url), 10000);
            //所有在js中使用的方法,这里都能使用
            Element element = document.getElementById("J_goodsList");
            //在获得网页内容后,获取所有的li标签
            Elements elements = element.getElementsByTag("li");

            //获取元素的标签后,再获取标签中的内容
            for (Element el : elements) {
                String skuCode = el.attr("data-sku");
                //关于图片特别多的网站,所拥有的图片都是延迟加载的(懒加载)
                // source-data-lazy-img
//            String img = el.getElementsByTag("img").eq(0).attr("source-data-lazy-img");
                String img = el.getElementsByTag("img").eq(0).attr("data-lazy-img");
                String price = el.getElementsByClass("p-price").eq(0).text();
                String name = el.getElementsByClass("p-name").eq(0).text();
                Goods goods = new Goods();
                goods.setSkuCode(skuCode);
                goods.setType(keywords);
                goods.setTitle(name);
                goods.setImg(img);
                goods.setPrice(price);
                goodList.add(goods);
            }
        }

        return goodList;
    }
}
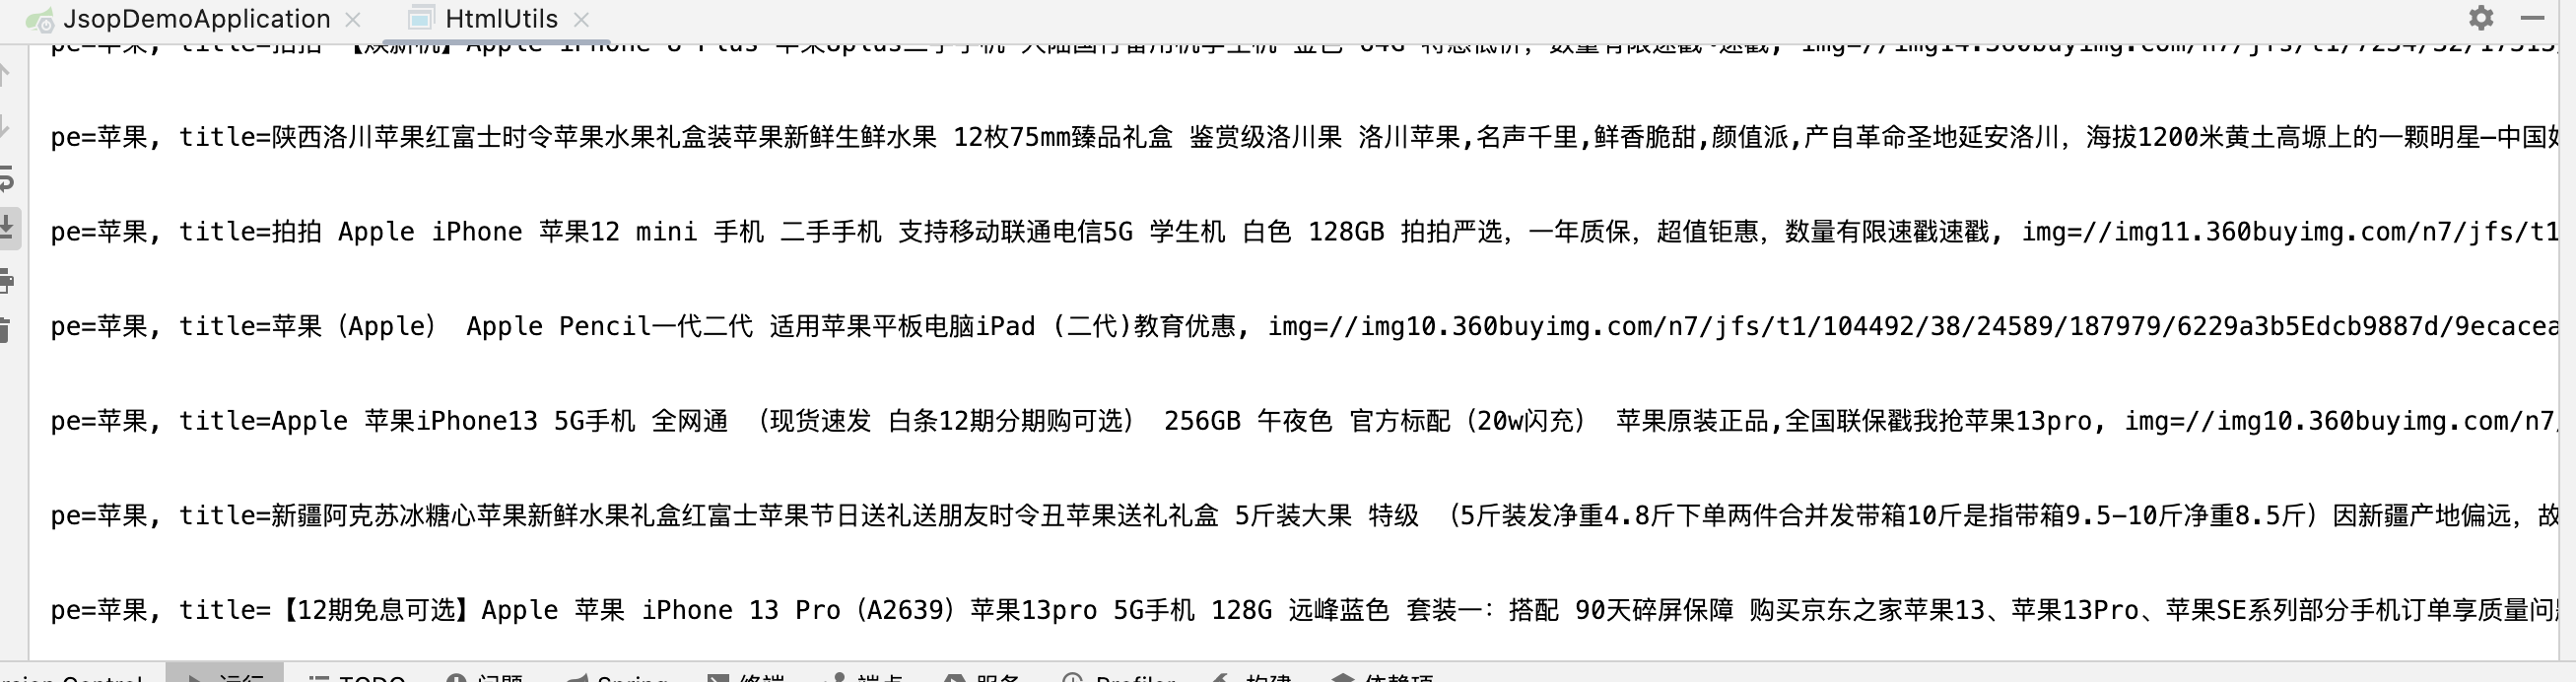
运行效果
四.数据存储
1.配置yml文件连接数据库
server:
  port: 8123
# 日志配置
logging:
  level:
    com.watone: debug
    org.springframework: info
spring:
  thymeleaf:
    mode: HTML
    encoding: utf-8
    servlet:
      content-type: text/html
    prefix: classpath:/templates/
  main:
    allow-bean-definition-overriding: true
  jackson:
    date-format: yyyy-MM-dd HH:mm:ss
    time-zone: GMT+8
  datasource:
    driver-class-name: com.mysql.cj.jdbc.Driver
    url: jdbc:mysql://数据库地址:3306/jsoup_goods?allowMultiQueries=true
    username: root
    password: 123456

mybatis:
  mapper-locations: classpath:mapper/*Mapper.xml
  type-aliases-package: com.guo.jsop.dto
2.数据库表 type是为了区分爬下来的不同类型数据
CREATE TABLE goods (
id int NOT NULL AUTO_INCREMENT,
type varchar(255) DEFAULT NULL,
title varchar(255) DEFAULT NULL,
img varchar(255) DEFAULT NULL,
price varchar(255) DEFAULT NULL,
sku_code varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci DEFAULT NULL,
PRIMARY KEY (id)
) ENGINE=InnoDB AUTO_INCREMENT=31 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
3.实体
package com.guo.jsop.dto;

import lombok.Data;

@Data
public class Goods {


    private Integer id;

    /**
     * 搜索关键字的类型
     */
    private String type;

    private String title;

    private String img;

    private String price;

    private String skuCode;

}
4.service and mapper.yml
@Resource
private GoodsMapper goodsMapper;

@Override
public Boolean grabGoods(String type, Integer num) {
    try {
        List<Goods> goods = HtmlUtils.parseJD(type, num);
        //删除老的type商品
        goodsMapper.delete(type);
        goodsMapper.insert(goods);
        return true;
    } catch (Exception e) {
        throw new RuntimeException(e);
    }
}
<insert id="insert" parameterType="java.util.List">
   insert into goods (type,title,img,price,sku_code) values
   <foreach collection ="goods" item="t" separator =",">
      (#{t.type}, #{t.title}, #{t.img},#{t.price},#{t.skuCode})
   </foreach>
</insert>

<delete id="delete" parameterType="java.lang.String">
   delete from goods where type = #{type}
</delete>
5.调用方式
http://localhost:8123/grabGoods?type=java&num=3
git地址