MySQL索引总结
索引是什么
官方介绍索引是帮助MySQL高效获取数据的数据结构。更通俗的说,数据库索引好比是一本书前面的目录,能加快数据库的查询速度。
一般来说索引本身也很大,不可能全部存储在内存中,因此索引往往是存储在磁盘上的文件中的(可能存储在单独的索引文件中,也可能和数据一起存储在数据文件中)。
我们通常所说的索引,包括聚集索引、覆盖索引、组合索引、前缀索引、唯一索引等,没有特别说明,默认都是使用B+树结构组织(多路搜索树,并不一定是二叉的)的索引
索引的优势和劣势
优势:
可以提高数据检索的效率,降低数据库的IO成本,类似于书的目录。
通过索引列对数据进行排序,降低数据排序的成本,降低了CPU的消耗。
被索引的列会自动进行排序,包括【单列索引】和【组合索引】,只是组合索引的排序要复杂一些。 如果按照索引列的顺序进行排序,对应order by语句来说,效率就会提高很多。
劣势:
索引会占据磁盘空间
索引虽然会提高查询效率,但是会降低更新表的效率。比如每次对表进行增删改操作,MySQL不仅要保存数据,还有保存或者更新对应的索引文件。
索引分类
主键索引
索引中的列值必须是唯一的,且不允许有空值
普通索引
允许定义索引的列存在重复的值或者是空值
创建索引
这是最基本的索引,它没有任何限制。它有以下几种创建方式:
CREATE INDEX indexName ON table_name (column_name)
唯一索引
CREATE UNIQUE INDEX indexName ON mytable(username(length))
删除索引
DROP INDEX [indexName] ON mytable;
空间索引
前缀索引
在文本类型char,varchar,text类型上创建索引时,可以指定索引列的长度,但是数值类型索引不能指定
其他(索引作用数量分类)
1.单列索引
2.组合索引
索引的数据结构
hash表
hash表,heshMap,TreeMap就是Hash表结构,以键值对的方式存储数据。我们使用hash表存储数据Key可以存储索引列,Value可以存储记录或者磁盘地址。Hash表在查询等值的效率很高,但是不支持范围快速查找。
二叉树
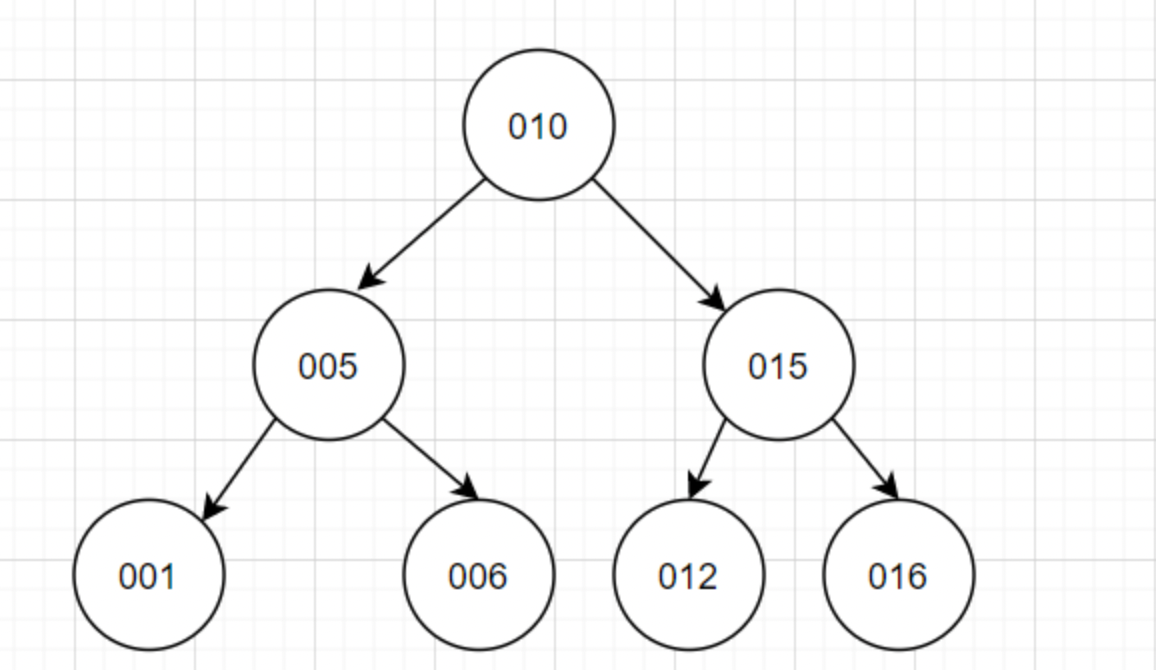
二叉树的特点:每个节点最多有两个分叉,左分叉的数小于右分叉
平衡二叉树
平衡二叉树是采用二分法思维,平衡二叉查找树除了具备二叉树的特点,最主要的特征是树的左右两个子树的层级最多相差1。在插入删除数据时通过左旋/右旋操作保持二叉树的平衡,不会出现左子树很高、右子树很矮的情况。
B树
MySQL的数据是存储在磁盘文件中的,查询处理数据时,需要先把磁盘中的数据加载到内存中,磁盘IO 操作非常耗时,所以我们优化的重点就是尽量减少磁盘 IO 操作。访问二叉树的每个节点就会发生一次IO,如果想要减少磁盘IO操作,就需要尽量降低树的高度。那如何降低树的高度呢?
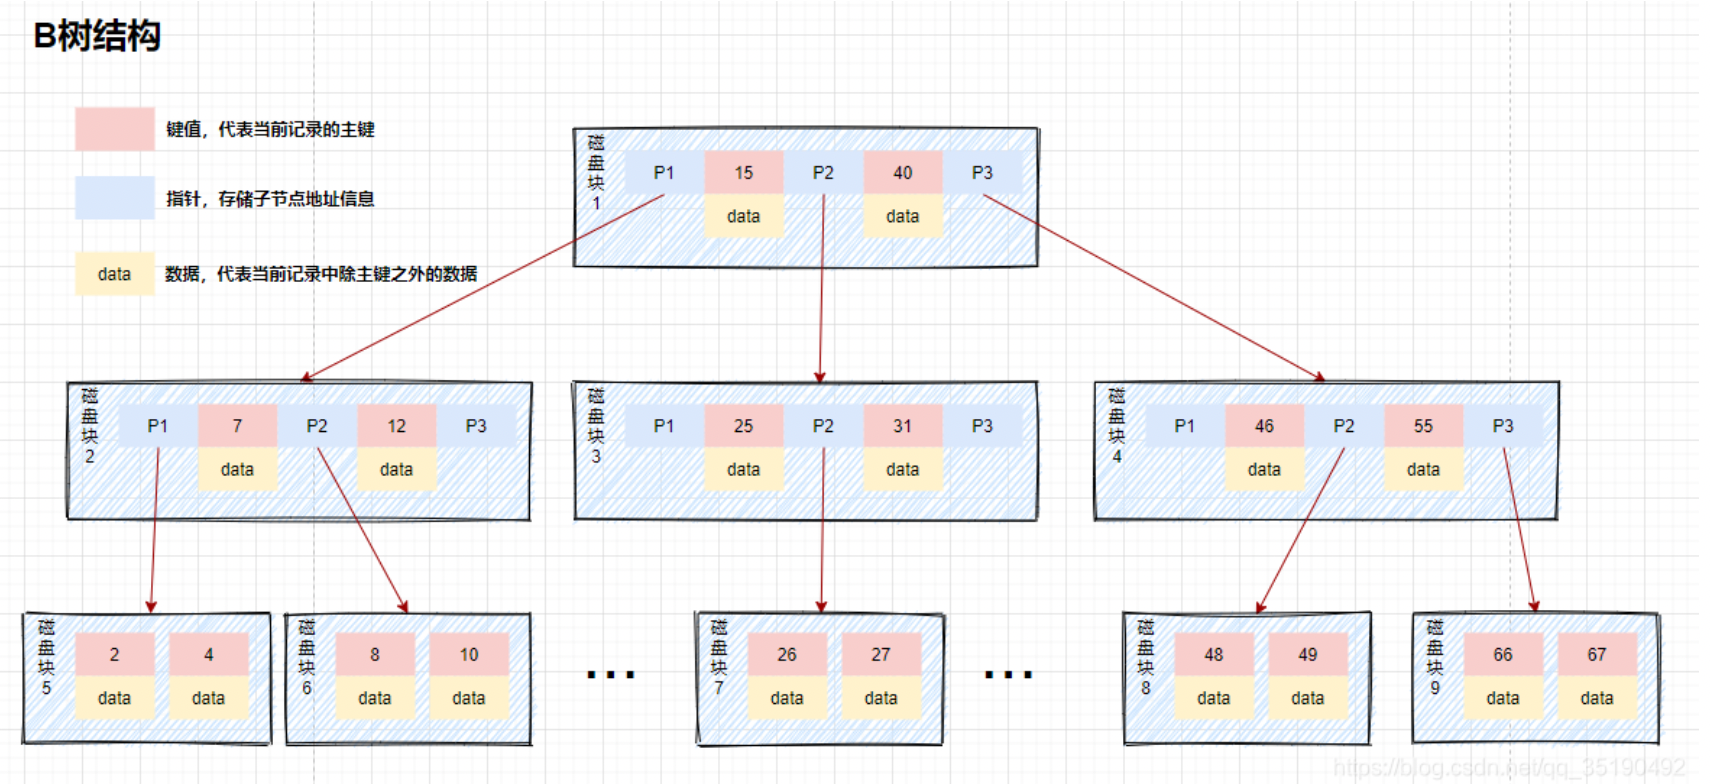
可以看到B+树可以保证等值和范围查询的快速查找,MySQL的索引就采用了B+树的数据结构。
B树待优化点待
B树不支持范围查询的快速查找,你想想这么一个情况如果我们想要查找10和35之间的数据,查找到15之后,需要回到根节点重新遍历查找,需要从根节点进行多次遍历,查询效率有待提高。
如果data存储的是行记录,行的大小随着列数的增多,所占空间会变大。这时,一个页中可存储的数据量就会变少,树相应就会变高,磁盘IO次数就会变大。
B+树:改造B树
B+树,作为B树的升级版,在B树基础上,MySQL在B树的基础上继续改造,使用B+树构建索引。B+树和B树最主要的区别在于非叶子节点是否存储数据的问题
跟B树的区别
B树:非叶子节点和叶子节点都会存储数据。
B+树:只有叶子节点才会存储数据,非叶子节点至存储键值。叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。
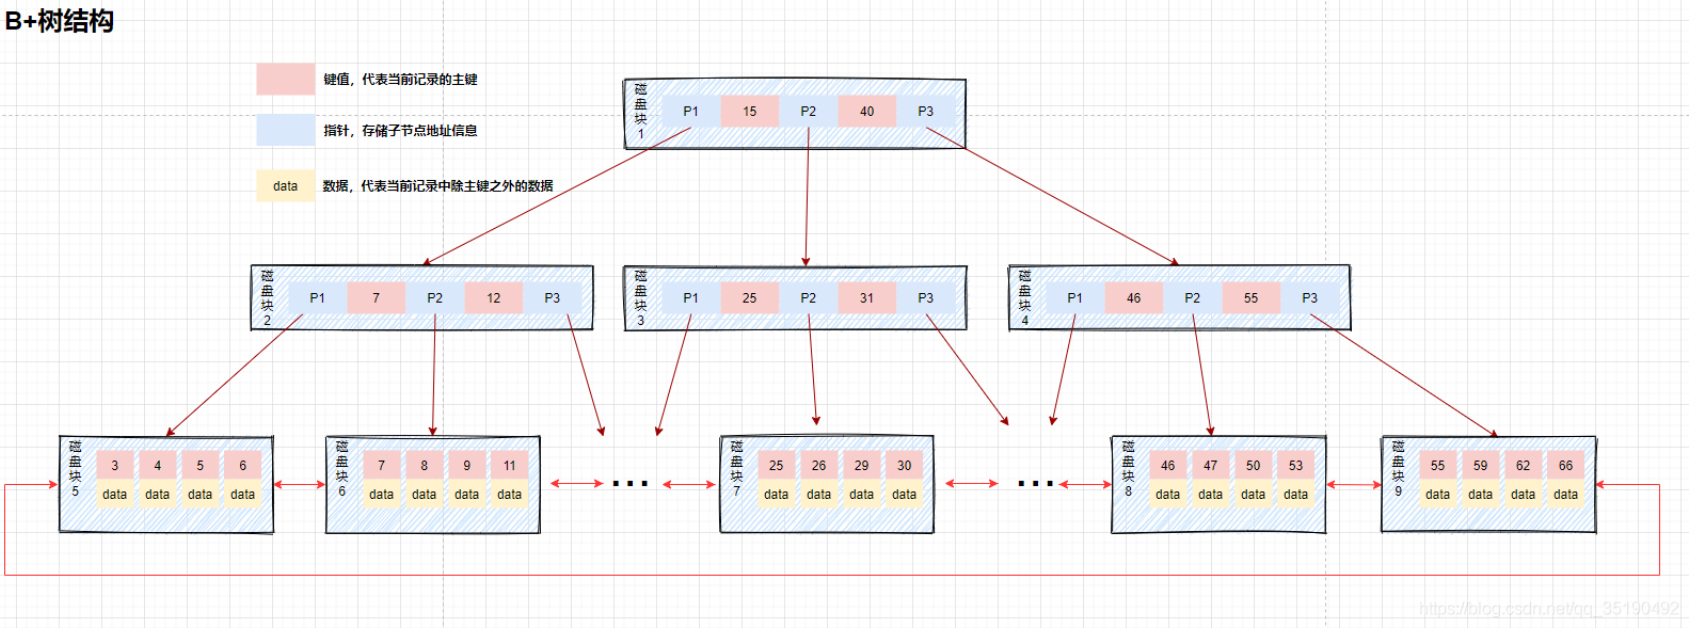
Mysql索引实现
Mylsam索引
主键索引
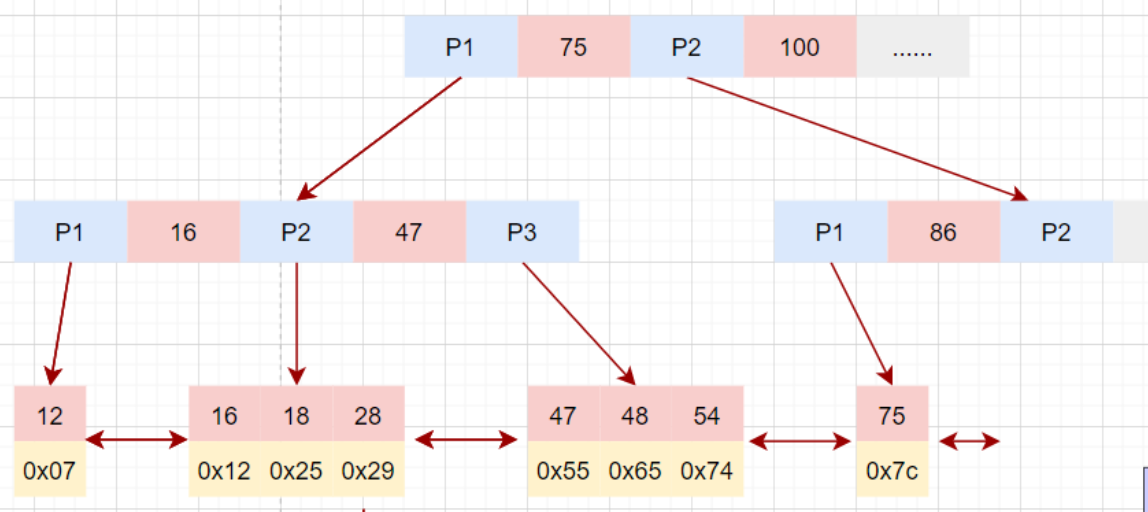
辅助索引
在 MyISAM 中,辅助索引和主键索引的结构是一样的,没有任何区别,叶子节点的数据存储的都是行记录的磁盘地址。只是主键索引的键值是唯一的,而辅助索引的键值可以重复。
查询数据时,由于辅助索引的键值不唯一,可能存在多个拥有相同的记录,所以即使是等值查询,也需要按照范围查询的方式在辅助索引树中检索数据。
InnoDB索引
主键索引(聚簇索引)
每个InnoDB表都有一个聚簇索引 ,聚簇索引使用B+树构建,叶子节点存储的数据是整行记录。一般情况下,聚簇索引等同于主键索引,当一个表没有创建主键索引时,InnoDB会自动创建一个ROWID字段来构建聚簇索引。InnoDB创建索引的具体规则如下:
在表上定义主键PRIMARY KEY,InnoDB将主键索引用作聚簇索引。
如果表没有定义主键,InnoDB会选择第一个不为NULL的唯一索引列用作聚簇索引。
如果以上两个都没有,InnoDB 会使用一个6 字节长整型的隐式字段 ROWID字段构建聚簇索引。该ROWID字段会在插入新行时自动递增。
组合索引
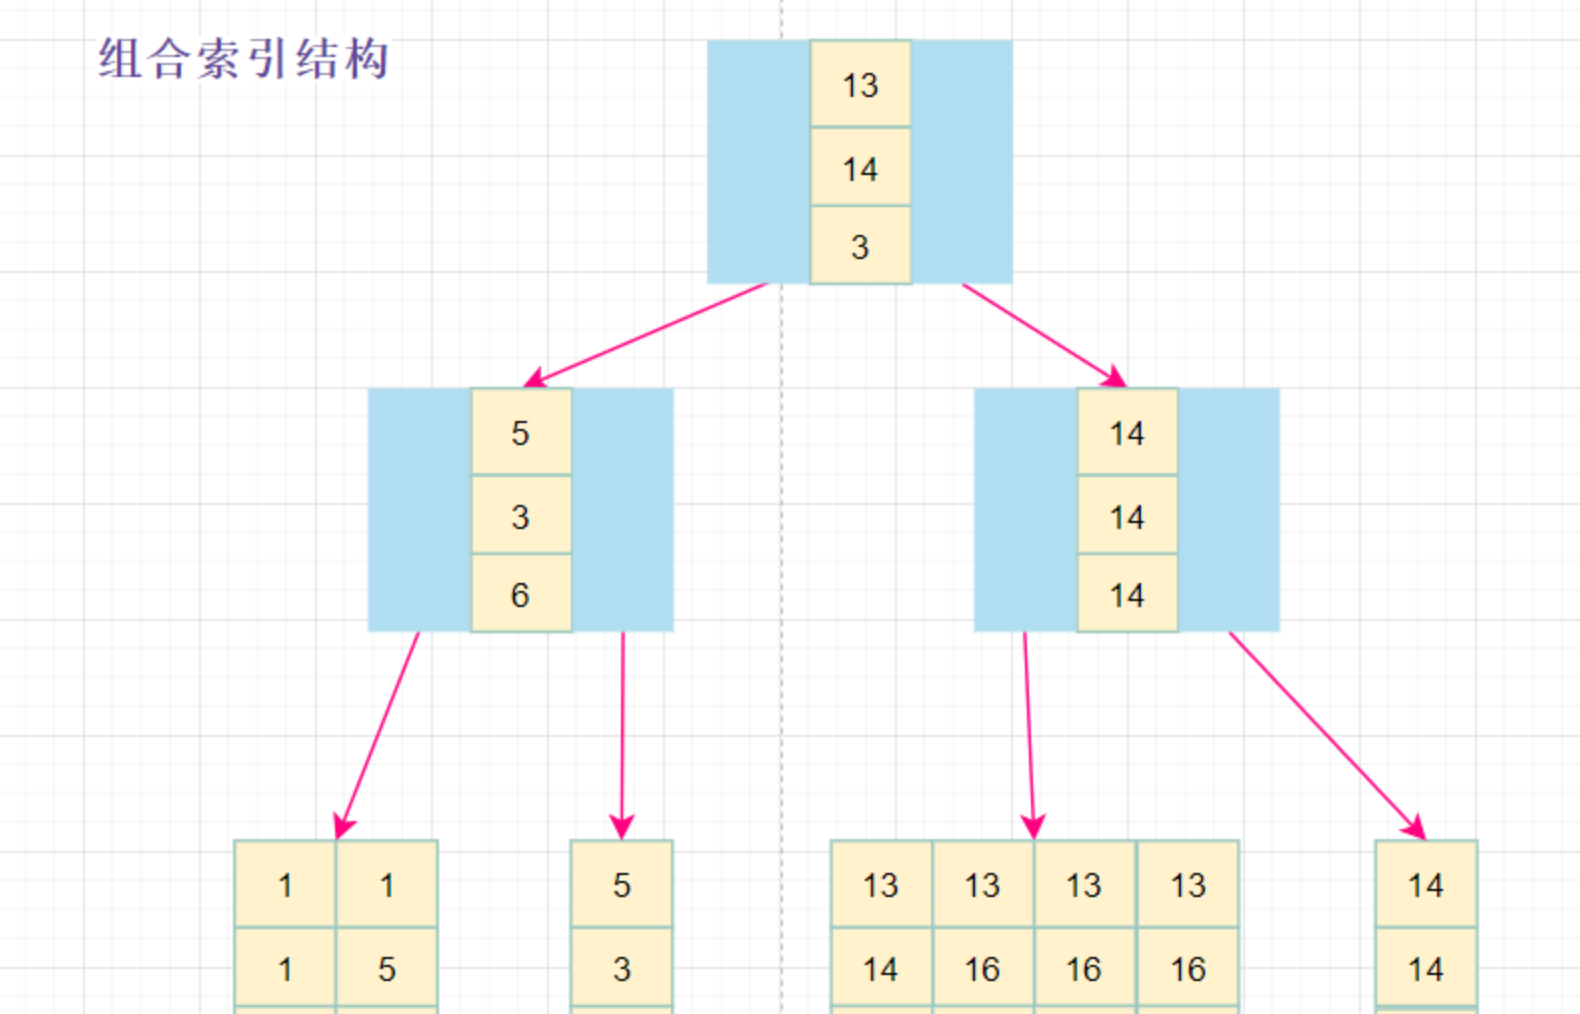
最左匹配原则:
最左前缀匹配原则和联合索引的索引存储结构和检索方式是有关系的。
在组合索引树中,最底层的叶子节点按照第一列a列从左到右递增排列,但是b列和c列是无序的,b列只有在a列值相等的情况下小范围内递增有序,而c列只能在a,b两列相等的情况下小范围内递增有序。
就像上面的查询,B+树会先比较a列来确定下一步应该搜索的方向,往左还是往右。如果a列相同再比较b列。但是如果查询条件没有a列,B+树就不知道第一步应该从哪个节点查起。
可以说创建的idx_abc(a,b,c)索引,相当于创建了(a)、(a,b)(a,b,c)三个索引。
避免回表
在InnoDB的存储引擎中,使用辅助索引查询的时候,因为辅助索引叶子节点保存的数据不是当前记录的数据而是当前记录的主键索引,索引如果需要获取当前记录完整数据就必然需要根据主键值从主键索引继续查询。这个过程我们成位回表。想想回表必然是会消耗性能影响性能。那如何避免呢?
使用索引覆盖,举个例子:现有User表(id(PK),name(key),sex,address,hobby…)
如果在一个场景下,select id,name,sex from user where name ='zhangsan';这个语句在业务上频繁使用到,而user表的其他字段使用频率远低于它,在这种情况下,如果我们在建立 name 字段的索引的时候,不是使用单一索引,而是使用联合索引(name,sex)这样的话再执行这个查询语句是不是根据辅助索引查询到的结果就可以获取当前语句的完整数据。这样就可以有效地避免了回表再获取sex的数据。
这里就是一个典型的使用覆盖索引的优化策略减少回表的情况。
联合索引的使用 联合索引,在建立索引的时候,尽量在多个单列索引上判断下是否可以使用联合索引。联合索引的使用不仅可以节省空间,还可以更容易的使用到索引覆盖。试想一下,索引的字段越多,是不是更容易满足查询需要返回的数据呢。比如联合索引(a_b_c),是不是等于有了索引:a,a_b,a_b_c三个索引,这样是不是节省了空间,当然节省的空间并不是三倍于(a,a_b,a_b_c)三个索引,因为索引树的数据没变,但是索引data字段的数据确实真实的节省了。
联合索引的创建原则,在创建联合索引的时候因该把频繁使用的列、区分度高的列放在前面,频繁使用代表索引利用率高,区分度高代表筛选粒度大,这些都是在索引创建的需要考虑到的优化场景,也可以在常需要作为查询返回的字段上增加到联合索引中,如果在联合索引上增加一个字段而使用到了覆盖索引,那我建议这种情况下使用联合索引。