基于ShardingSphere水平分表的两种方式实践
分库分表(水平拆分)
1.分库分表方案
之前工作的时候其实有做过分库分表,但是因为上家公司工具化比较好,只需简单配置即可。当时候项目也比较赶,后来也就没有深究思考,最近刚想起来。如果你想要复现一遍的话,建议一定要看看官网。apache也为我们提供了多种方式,此文是基于apache—ShardingSphereJDBC的实操demo。
Sharding-JDBC
定位为轻量级 Java 框架,在 Java 的 JDBC 层提供的额外服务。 它使用客户端直连数据库,以 jar 包形式提供服务,无需额外部署和依赖,可理解为增强版的 JDBC 驱动,完全兼容 JDBC 和各种 ORM 框架。
- 适用于任何基于 Java 的 ORM 框架,如:JPA, Hibernate, Mybatis, Spring JDBC Template 或直接使用 JDBC。
- 基于任何第三方的数据库连接池,如:DBCP, C3P0, BoneCP, Druid, HikariCP 等。
- 支持任意实现 JDBC 规范的数据库。目前支持 MySQL,Oracle,SQLServer 和 PostgreSQL。
Sharding-Proxy
定位为透明化的数据库代理端,提供封装了数据库二进制协议的服务端版本,用于完成对异构语言的支持。 目前先提供 MySQL/PostgreSQL 版本,它可以使用任何兼容 MySQL/PostgreSQL 协议的访问客户端(如:MySQL Command Client, MySQL Workbench, Navicat 等)操作数据,对 DBA 更加友好。
- 向应用程序完全透明,可直接当做 MySQL/PostgreSQL 使用。
- 适用于任何兼容 MySQL/PostgreSQL 协议的的客户端。
ShardingSphere官网:https://shardingsphere.apache.org/
2.什么时候分表?
如果你的系统处于快速发展时期,表的查询效率明变慢时,就需要规划分库分表了。一般B+树索引高度是2~3层最佳,如果数据量千万级别,可能高度就变4层了,数据量就会明显变慢了。参照阿里规范一般500万数据就要考虑分表了。
3.什么时候分库
业务发展很快,还是多个服务共享一个单体数据库,数据库成为了性能瓶颈,就需要考虑分库了。比如订单、用户等,都可以抽取出来,新搞个应用(其实就是微服务思想),并且拆分数据库(订单库、用户库)。
4.水平分库
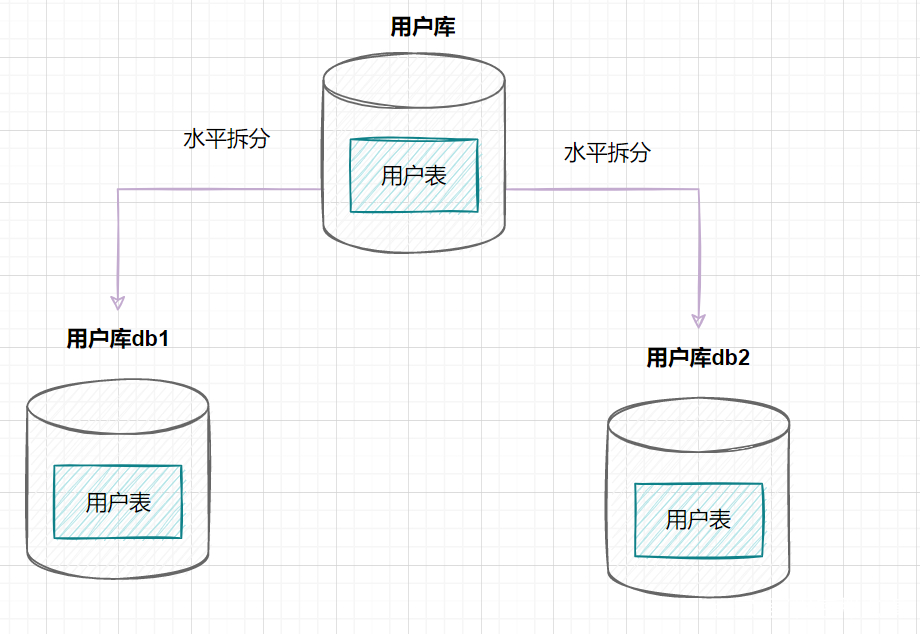
水平分库是指,将表的数据量切分到不同的数据库服务器上,每个服务器具有相同的库和表,只是表中的数据集合不一样。它可以有效的缓解单机单库的性能瓶颈和压力。
用户库的水平拆分架构如下:
4.1range方案(分库同理)
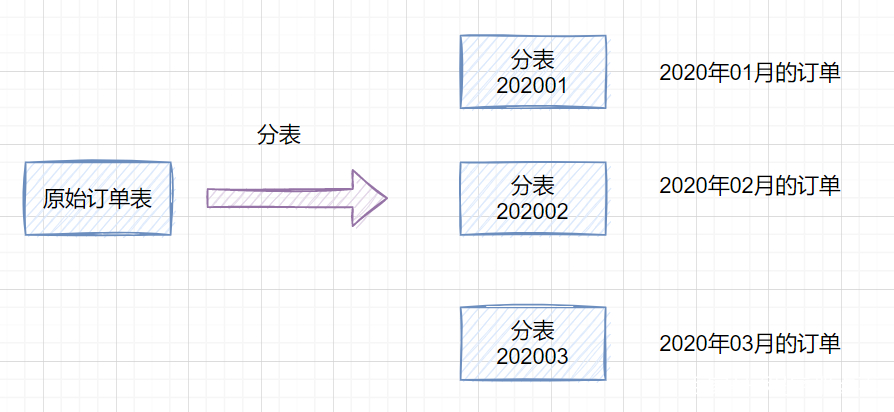
如果一个表的数据量太大,可以按照某种规则(如hash取模、range),把数据切分到多张表去。
一张订单表,按时间range拆分如下:
4.2hash取模方案(分库同理)
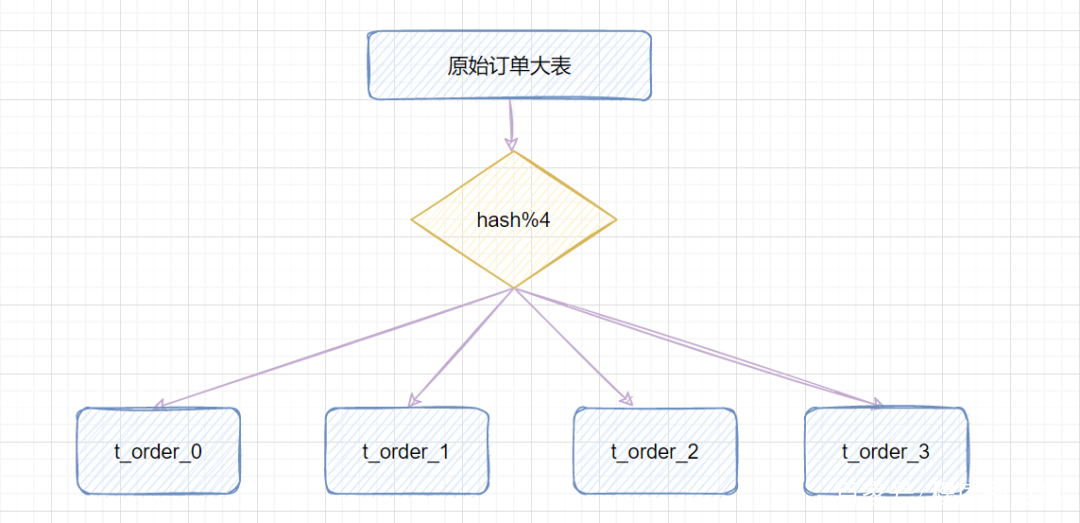
hash取模策略:指定的路由key(一般是user_id、订单id作为key)对分表总数进行取模,把数据分散到各个表中。
比如原始订单表信息,我们把它分成4张分表:
5.hash取模方案实战
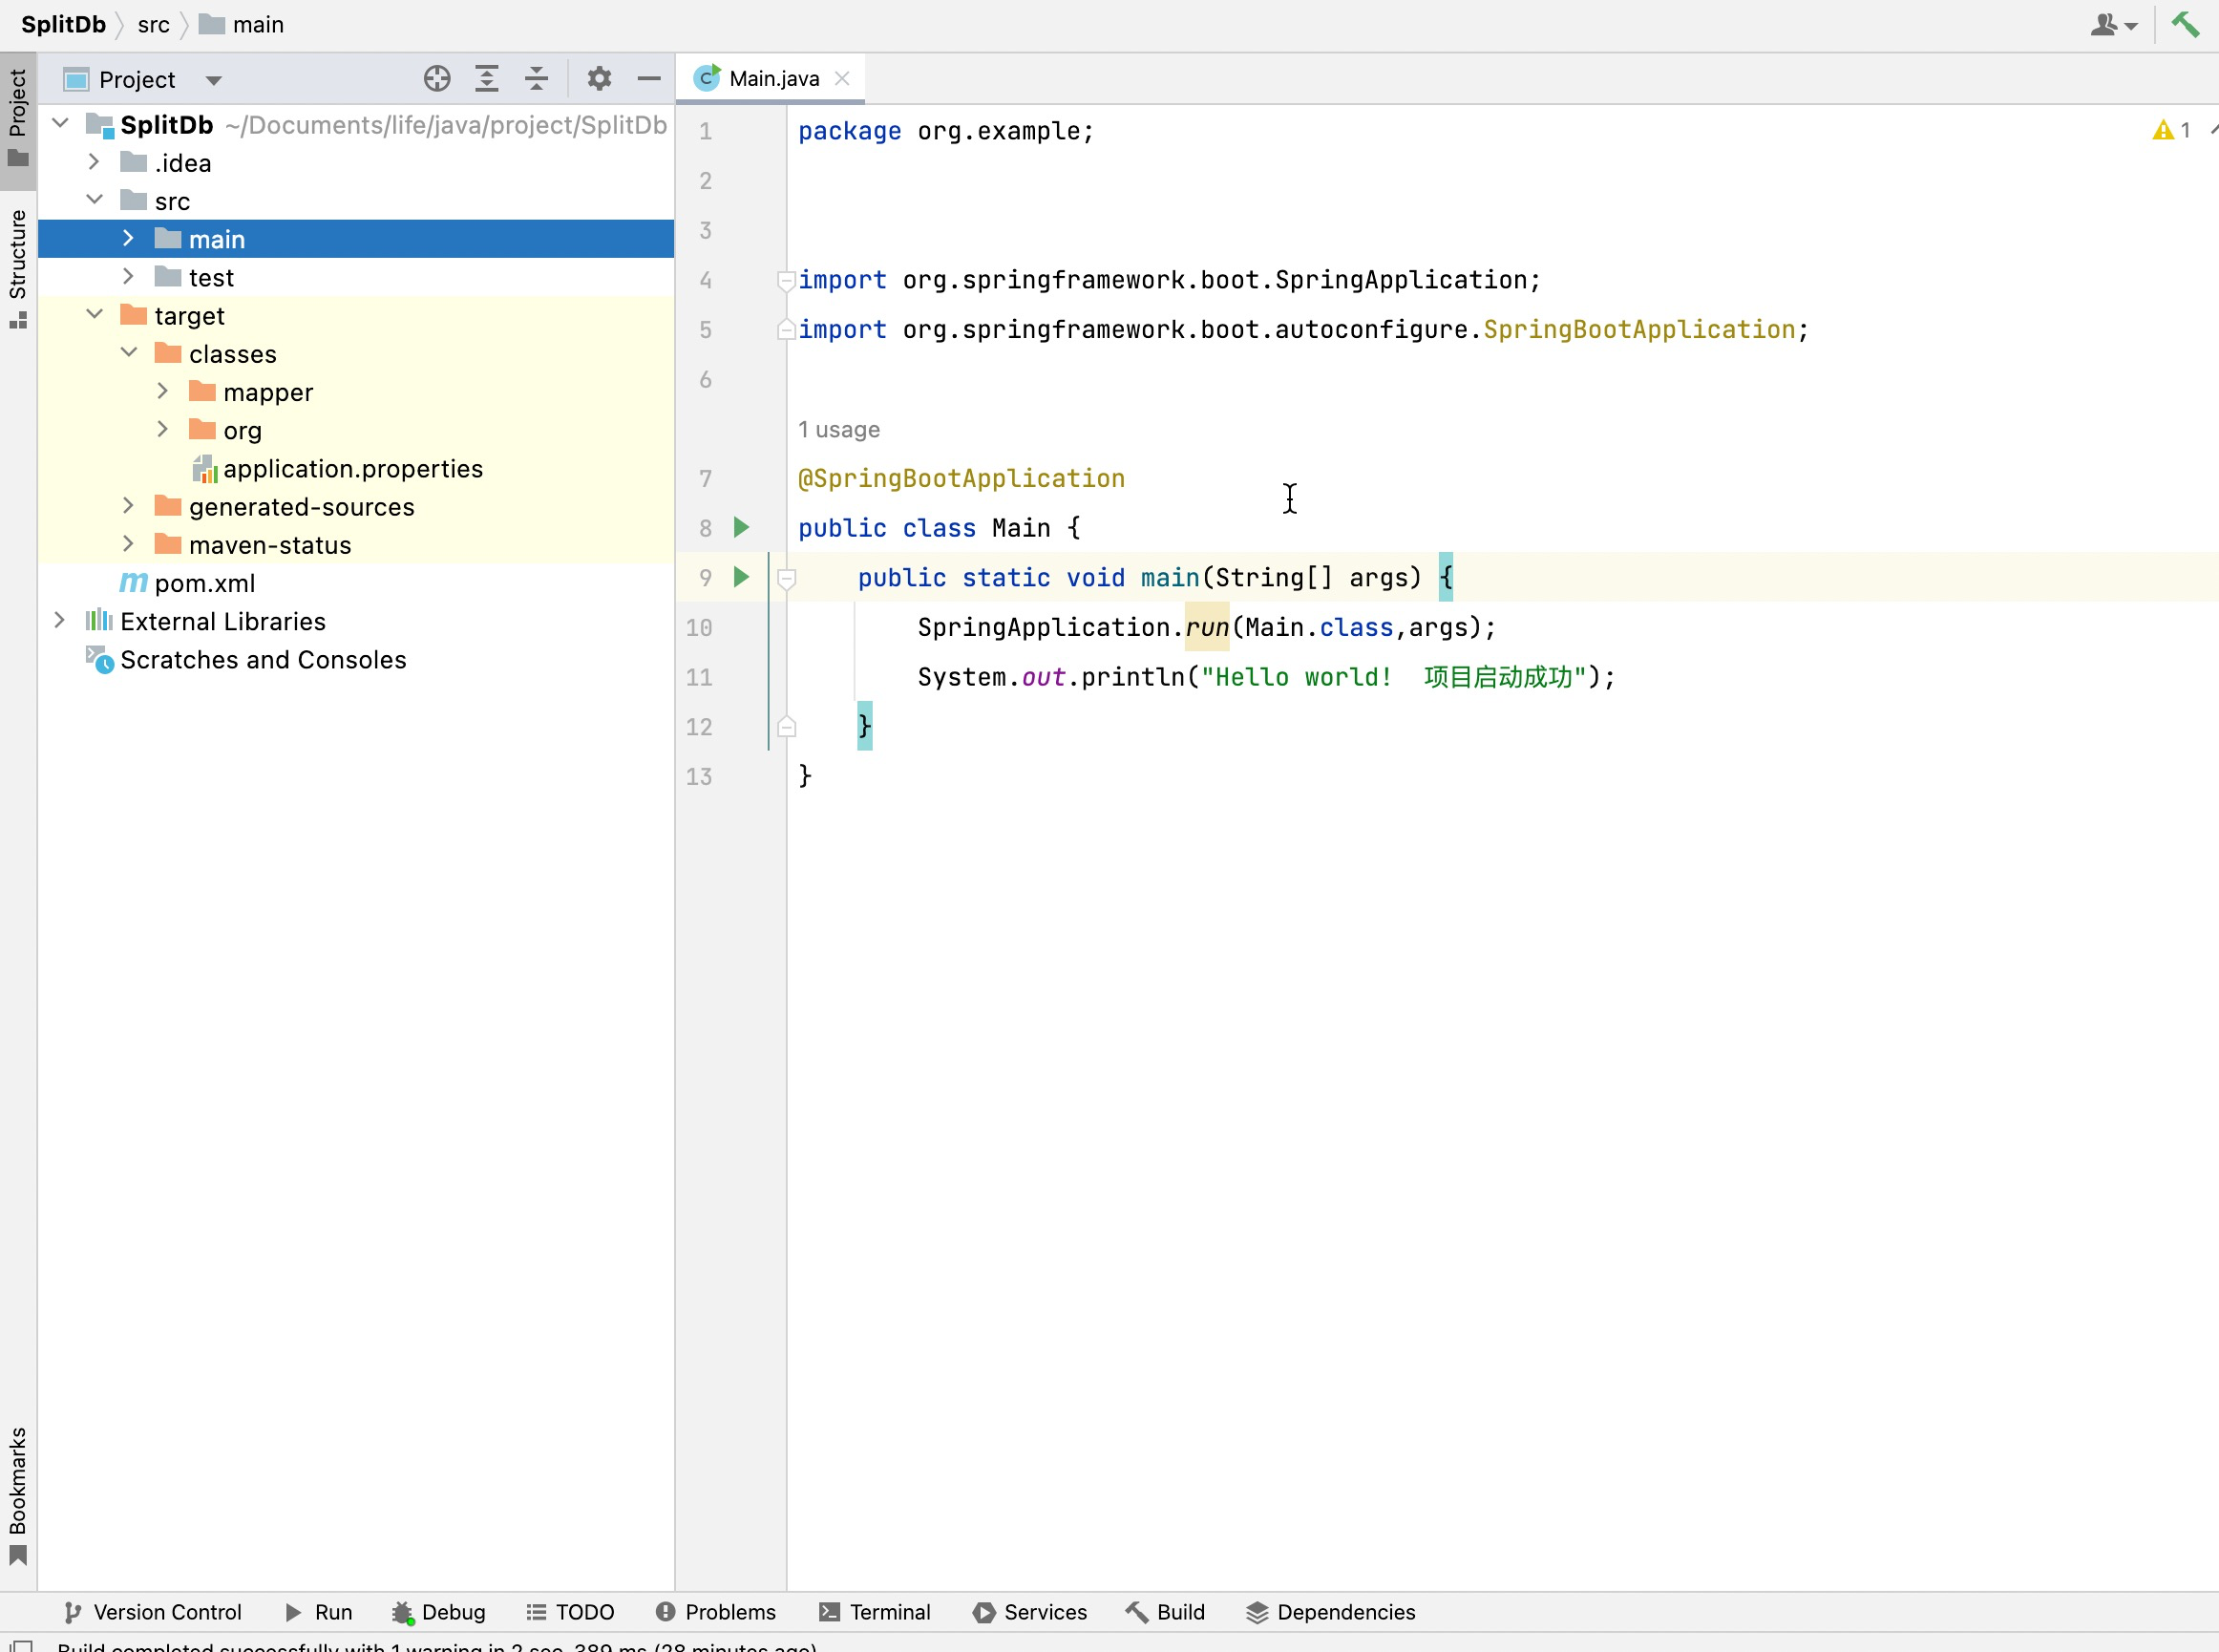
5.1新建一个springBoot项目
5.2引入mysql,shardingsphere,lombok等所需要的依赖包
<dependencies>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-web</artifactId>
    </dependency>

    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-test</artifactId>
        <scope>test</scope>
    </dependency>
    <!--mysql-->
    <dependency>
        <groupId>mysql</groupId>
        <artifactId>mysql-connector-java</artifactId>
        <scope>runtime</scope>
    </dependency>
    <!--Mybatis-Plus-->
    <dependency>
        <groupId>com.baomidou</groupId>
        <artifactId>mybatis-plus-boot-starter</artifactId>
        <version>3.1.1</version>
    </dependency>
    <!--shardingsphere start-->
    <dependency>
        <groupId>io.shardingsphere</groupId>
        <artifactId>sharding-jdbc-spring-boot-starter</artifactId>
        <version>3.1.0</version>
    </dependency>
    <!-- for spring namespace -->
    <dependency>
        <groupId>io.shardingsphere</groupId>
        <artifactId>sharding-jdbc-spring-namespace</artifactId>
        <version>3.1.0</version>
    </dependency>
    <!--shardingsphere end-->
    <!--lombok-->
    <dependency>
        <groupId>org.projectlombok</groupId>
        <artifactId>lombok</artifactId>
        <version>1.18.8</version>
    </dependency>
</dependencies>
5.3创建数据库and表需要用到的,只为了实践一个demo数据库结构比较简单
新建数据库 ds0,ds1
每个库各包含两个表(user_0,user_1)
5.3.1数据库a
CREATE DATABASE IF NOT EXISTS ds0 /*!40100 DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci */; USE ds0; SET NAMES utf8mb4;
5.3.2数据库a的表
CREATE TABLE user_0 (
id int NOT NULL,
name varchar(255) DEFAULT NULL,
age int DEFAULT NULL,
PRIMARY KEY (id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
CREATE TABLE user_1 (
id int NOT NULL,
name varchar(255) DEFAULT NULL,
age int DEFAULT NULL,
PRIMARY KEY (id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
5.3.3数据库b
CREATE DATABASE IF NOT EXISTS ds1 /*!40100 DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci */; USE ds0; SET NAMES utf8mb4;
5.3.4数据库b的表
CREATE TABLE user_0 (
id int NOT NULL,
name varchar(255) DEFAULT NULL,
age int DEFAULT NULL,
PRIMARY KEY (id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
CREATE TABLE user_1 (
id int NOT NULL,
name varchar(255) DEFAULT NULL,
age int DEFAULT NULL,
PRIMARY KEY (id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
5.4.application.properties配置文件(核心)
a.配置了两个数据源库
b.配置了以id为准的分库标准(ds$->{id % 2}),这个算法个人理解类似于除法,比如id是100,分8个库(ds$->{100% 8})余数为4 那就在ds4这个库里,除尽的话在ds0库
c.要注意,我们分表后主键自增id就不可用了,因为表不同,所以主键会有重复。这里使用的是uuid,但是因为uuid是一个长位字符串,这样的话如果使用它作为分表依据的话查询效率会有影响。如果数据量不大的话其实可以开一个表专门用于生产id主键。还有一种分案是可以通过设表的自增字段步长来进行水平伸缩。
比如说,现在有 8 个服务节点,每个服务节点使用一个 sequence 功能来产生 ID,每个 sequence 的起始 ID 不同,并且依次递增,步长都是8

适合的场景:在用户防止产生的 ID 重复时,这种方案实现起来比较简单,也能达到性能目标。但是服务节点固定,步长也固定,将来如果还要增加服务节点,就不好搞了。
e.分库规则,id单数在ds1库,双数在ds0
f.分表规则,age单数在user1,双数在dso
提供application.properties文件(记得替换数据库配置)
server.port=8888

# 数据源 ds0,ds1
sharding.jdbc.datasource.names=ds0,ds1
# 第一个数据库
sharding.jdbc.datasource.ds0.type=com.zaxxer.hikari.HikariDataSource
sharding.jdbc.datasource.ds0.driver-class-name=com.mysql.cj.jdbc.Driver
sharding.jdbc.datasource.ds0.jdbc-url=jdbc:mysql://你的主机:3306/ds0?characterEncoding=utf-8&&serverTimezone=GMT%2B8
sharding.jdbc.datasource.ds0.username=root
sharding.jdbc.datasource.ds0.password=990522

# 第二个数据库
sharding.jdbc.datasource.ds1.type=com.zaxxer.hikari.HikariDataSource
sharding.jdbc.datasource.ds1.driver-class-name=com.mysql.cj.jdbc.Driver
sharding.jdbc.datasource.ds1.jdbc-url=jdbc:mysql://你的主机:3306/ds1?characterEncoding=utf-8&&serverTimezone=GMT%2B8
sharding.jdbc.datasource.ds1.username=root
sharding.jdbc.datasource.ds1.password=990522

# 水平拆分的数据库(表) 配置分库 + 分表策略 行表达式分片策略
# 分库策略
sharding.jdbc.config.sharding.default-database-strategy.inline.sharding-column=id
sharding.jdbc.config.sharding.default-database-strategy.inline.algorithm-expression=ds$->{id % 2}

# 分表策略 其中user为逻辑表 分表主要取决于age行
sharding.jdbc.config.sharding.tables.user.actual-data-nodes=ds$->{0..1}.user_$->{0..1}
sharding.jdbc.config.sharding.tables.user.table-strategy.inline.sharding-column=age
# 分片算法表达式
sharding.jdbc.config.sharding.tables.user.table-strategy.inline.algorithm-expression=user_$->{age % 2}

# 主键 UUID 18位数 如果是分布式还要进行一个设置 防止主键重复
#sharding.jdbc.config.sharding.tables.user.key-generator-column-name=id

# 打印执行的数据库以及语句
sharding.jdbc.config.props..sql.show=true
spring.main.allow-bean-definition-overriding=true
5.5代码比较简单直接贴出来了
Controller
package org.example.controller;


import org.example.entity.User;
import org.example.service.UserService;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

import java.util.List;

@RestController
public class UserController {

    @Autowired
    private UserService userService;

    @GetMapping("/select")
    public List<User> select(User user) {
        return userService.getUserList();
    }

    @GetMapping("/insert")
    public Boolean insert(User user) {
        return userService.save(user);
    }

}
server
package org.example.service;


import com.baomidou.mybatisplus.extension.service.IService;
import org.example.entity.User;
import org.springframework.stereotype.Service;

import java.util.List;

@Service
public interface UserService extends IService<User> {

    /**
     * 保存用户信息
     *
     * @param entity
     * @return
     */
    @Override
    boolean save(User entity);

    /**
     * 查询全部用户信息
     *
     * @return
     */
    List<User> getUserList();
}
server实现
package org.example.service.impl;

import com.baomidou.mybatisplus.core.toolkit.Wrappers;
import com.baomidou.mybatisplus.extension.service.impl.ServiceImpl;
import org.example.dao.UserMapper;
import org.example.entity.User;
import org.example.service.UserService;
import org.springframework.stereotype.Service;

import java.util.List;

@Service
public class UserServiceImpl extends ServiceImpl<UserMapper, User> implements UserService {
    @Override
    public boolean save(User entity) {
        return super.save(entity);
    }

    @Override
    public List<User> getUserList() {
        return baseMapper.selectList(Wrappers.<User>lambdaQuery());
    }

}
dao
package org.example.dao;


import com.baomidou.mybatisplus.core.mapper.BaseMapper;
import org.apache.ibatis.annotations.Mapper;
import org.example.entity.User;


/**
 * user dao层
 * @author lihaodong
 */
@Mapper
public interface UserMapper extends BaseMapper<User> {

}
实体
package org.example.entity;

import com.baomidou.mybatisplus.annotation.TableName;
import com.baomidou.mybatisplus.extension.activerecord.Model;
import lombok.Data;
import lombok.EqualsAndHashCode;
import lombok.experimental.Accessors;

@Data
@EqualsAndHashCode(callSuper = true)
@Accessors(chain = true)
@TableName("user")
public class User extends Model<User> {

    /**
     * 主键Id
     */
    private Integer id;

    /**
     * 名称
     */
    private String name;

    /**
     * 年龄
     */
    private Integer age;
}
5.6验证hash分库分表
插入数据测试一下,写一个测试方式
@GetMapping("/add")
public Boolean add(User user) {
    ArrayList<User> users = new ArrayList<>();
     for (int i = 0; i < 10; i++) {
         users.add(new User(1,"张一",20));
         users.add(new User(2,"张二",21));
         users.add(new User(3,"张三",22));
         users.add(new User(4,"张四",24));
         users.add(new User(5,"张五",25));
         users.add(new User(6,"张六",26));
         users.add(new User(7,"张七",27));
         users.add(new User(8,"张八",28));
         users.add(new User(9,"张九",29));
         users.add(new User(10,"张百万",99));
    }
    for (User user1 : users) {
        userService.save(user1);
    }
    return true;
}
按照我们定义好的id分库规则
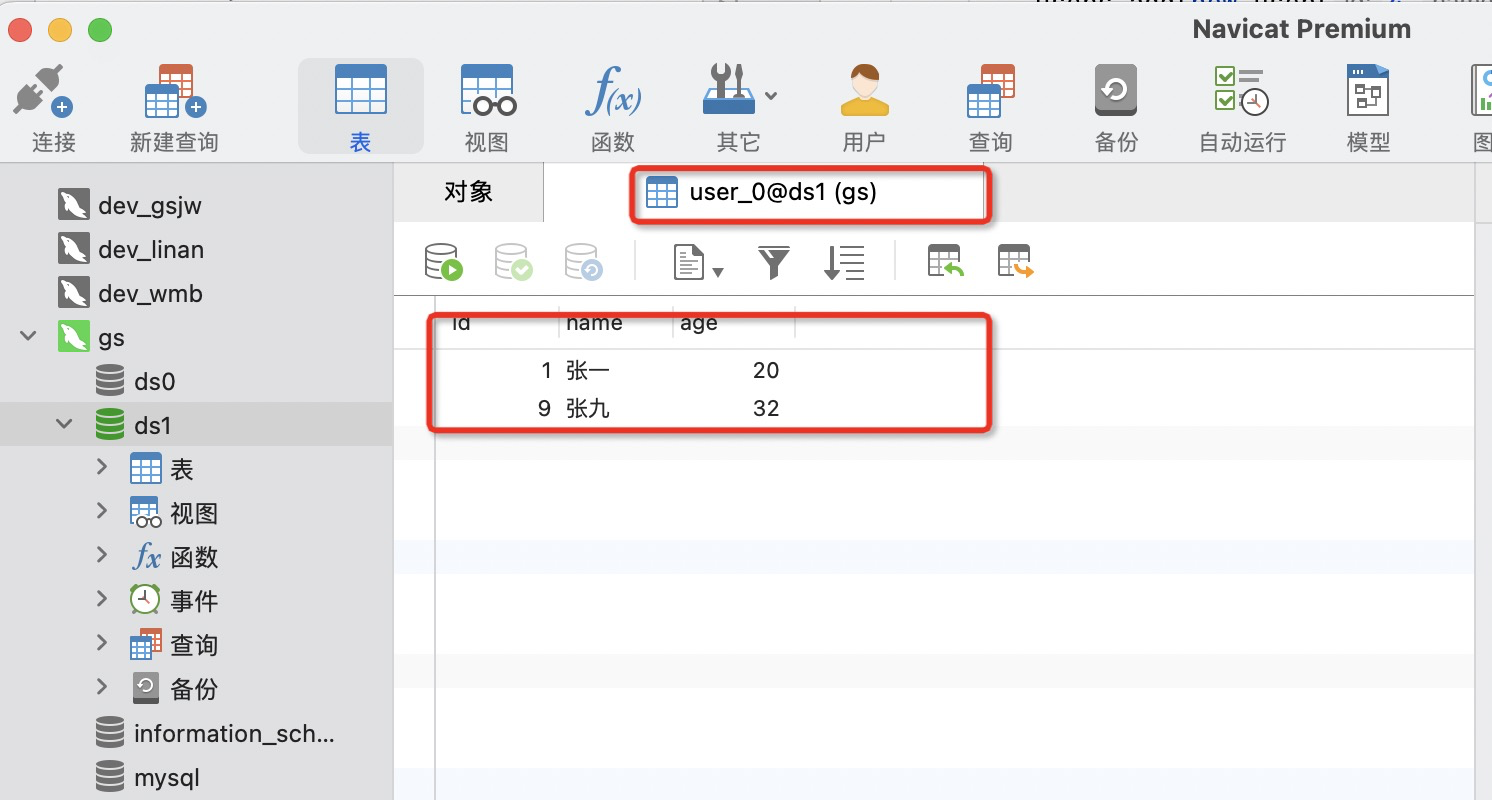
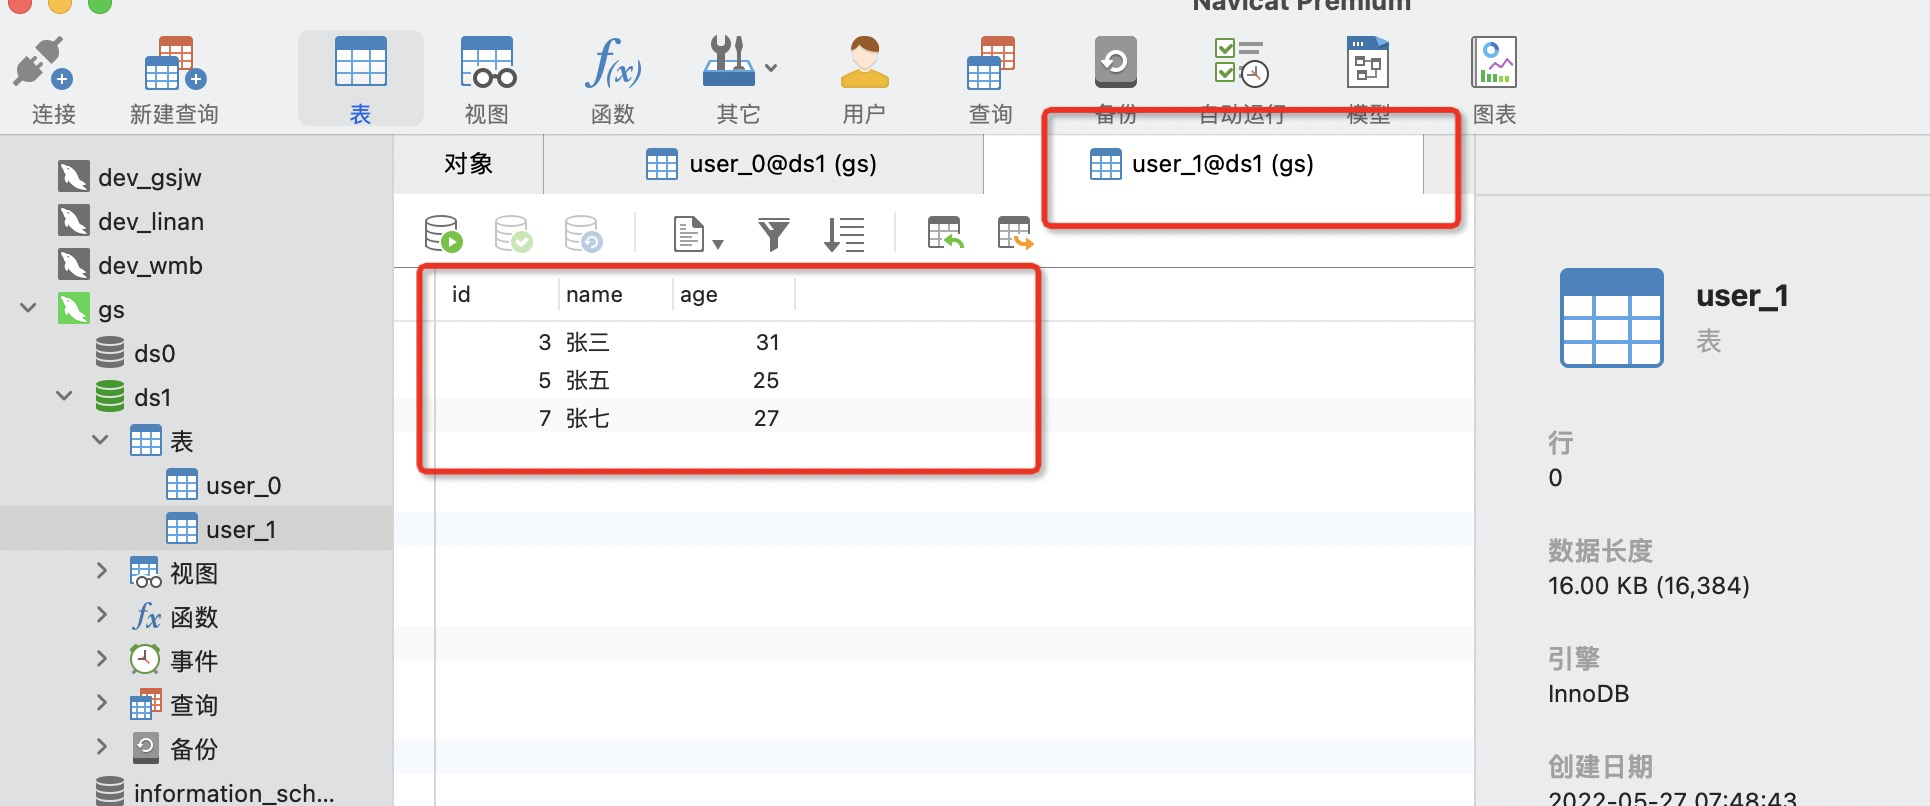
id为 1,3 ,5, 7,9的数据应该在ds1库
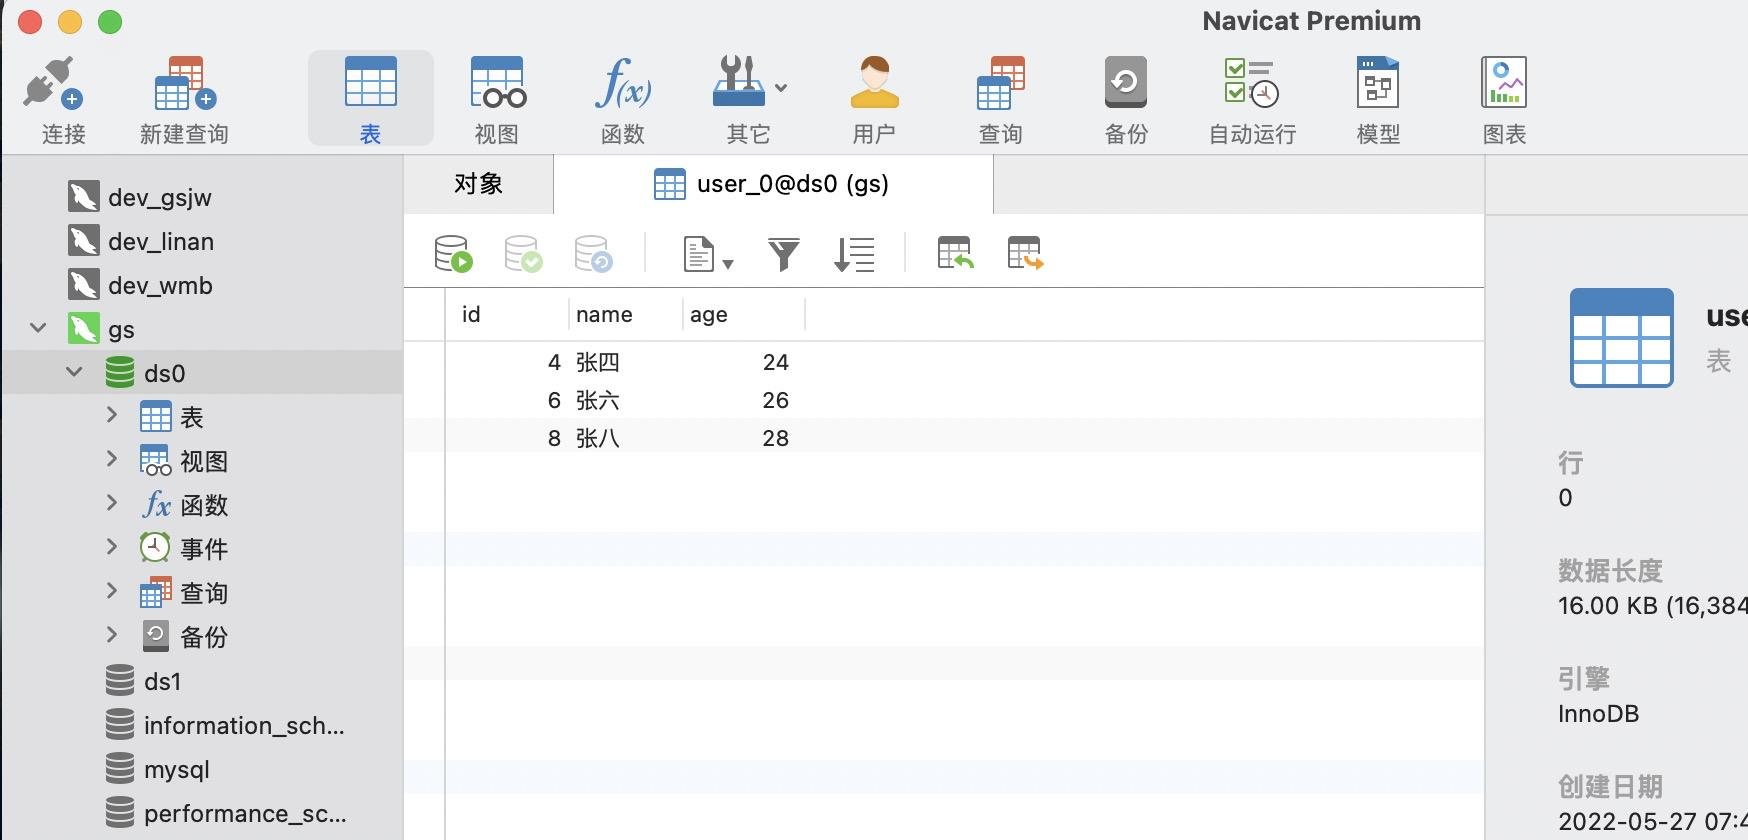
id为 2,4,6,8,10 应该在ds0库
ds1库中
use_0表中,应该有数据
users.add(new User(1,"张一",20));
users.add(new User(9,"张九",32));
user_1中应该有数据
users.add(new User(3,"张三",31));
users.add(new User(5,"张五",25));
users.add(new User(7,"张七",27));
ds0库中
user_0表中
users.add(new User(4,"张四",24));
users.add(new User(6,"张六",26));
users.add(new User(8,"张八",28));
user_1表中
users.add(new User(2,"张二",21));
users.add(new User(10,"张百万",99));
直接http方式调用http://localhost:8888/add
看结果
Ds1
ds0
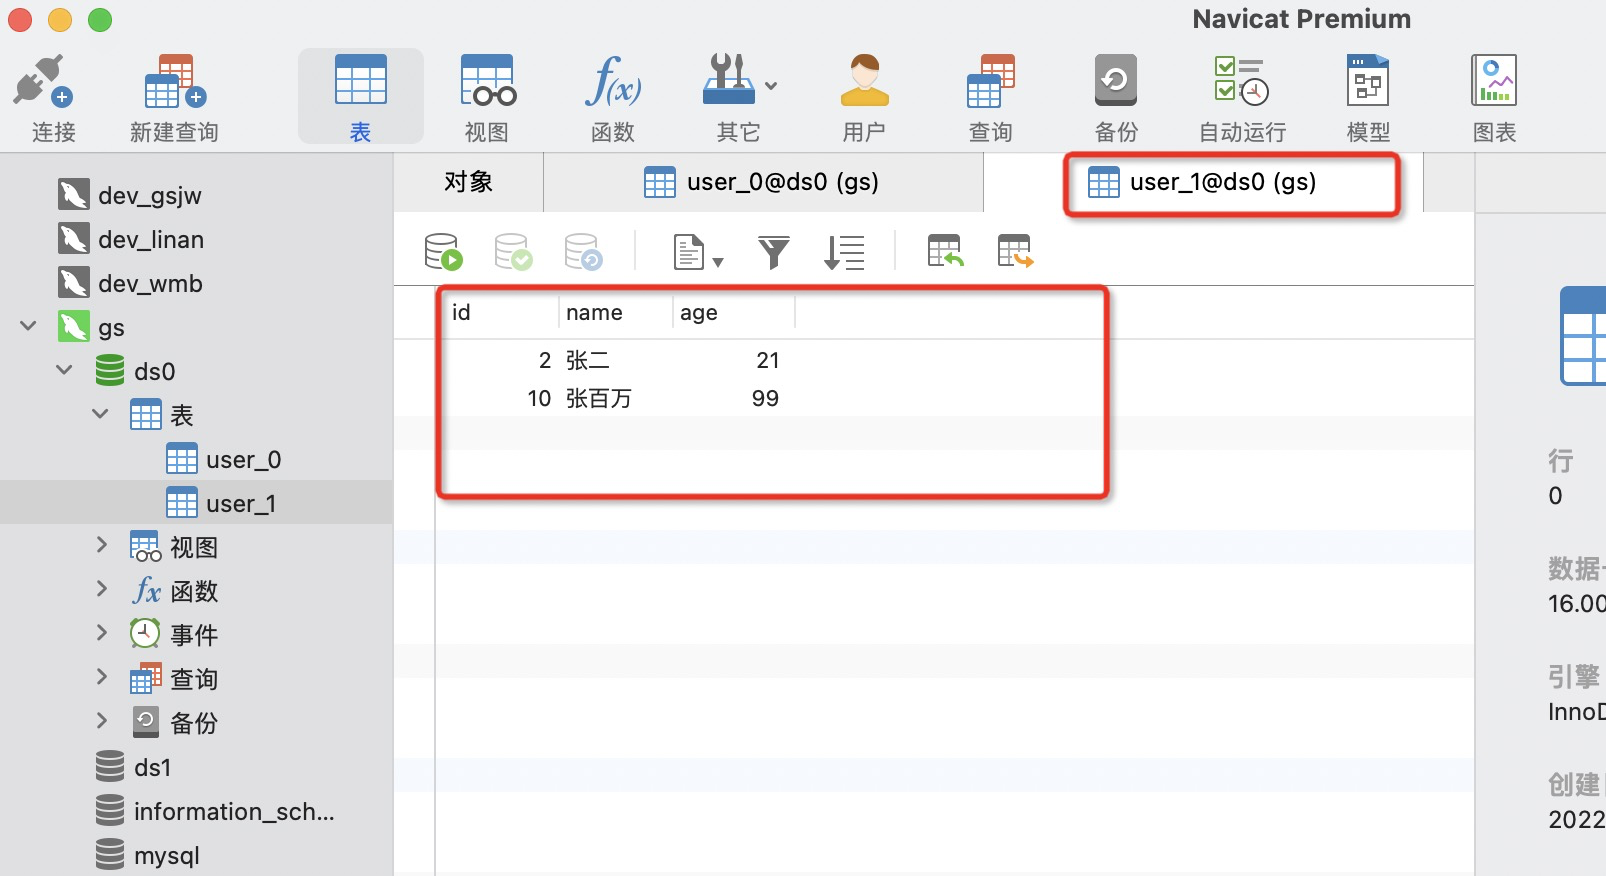
7.查询分析
7.1带分库分表参数
@GetMapping("/select")
public List<User> select(User user) {
    return userService.getUserList(user);
}
public List<User> getUserList(User user) {
    LambdaQueryWrapper<User> userLambdaQueryWrapper = Wrappers.<User>lambdaQuery();
    userLambdaQueryWrapper.eq(null != user.getId(),User::getId,user.getId());
    userLambdaQueryWrapper.eq(null != user.getAge(),User::getAge,user.getAge());
    userLambdaQueryWrapper.eq(!StringUtils.isEmpty(user.getName()),User::getName,user.getName());
    return baseMapper.selectList(userLambdaQueryWrapper);
}
7.2不携带分库分表参数
直接http调用http://localhost:8888/select?name=ceshi
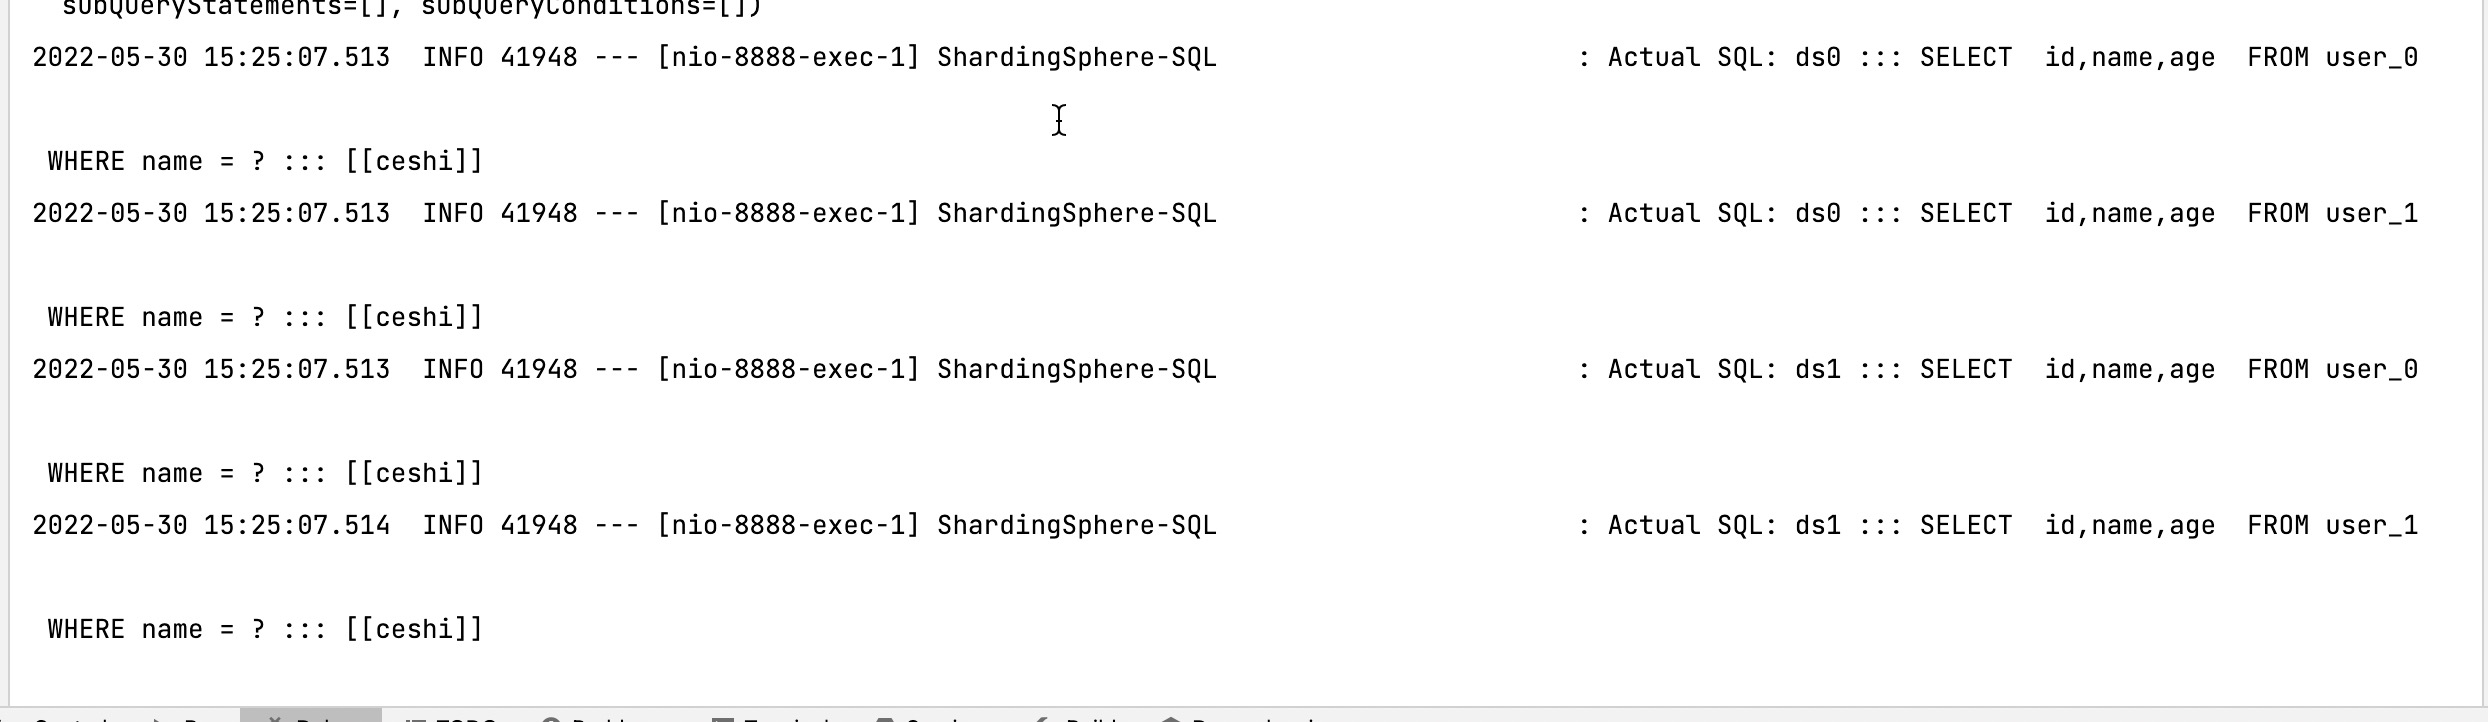
查询了我们的2个数据库and每个数据库下面的两张表
7.3带分库的参数
查询链接and参数http://localhost:8888/select?id=2
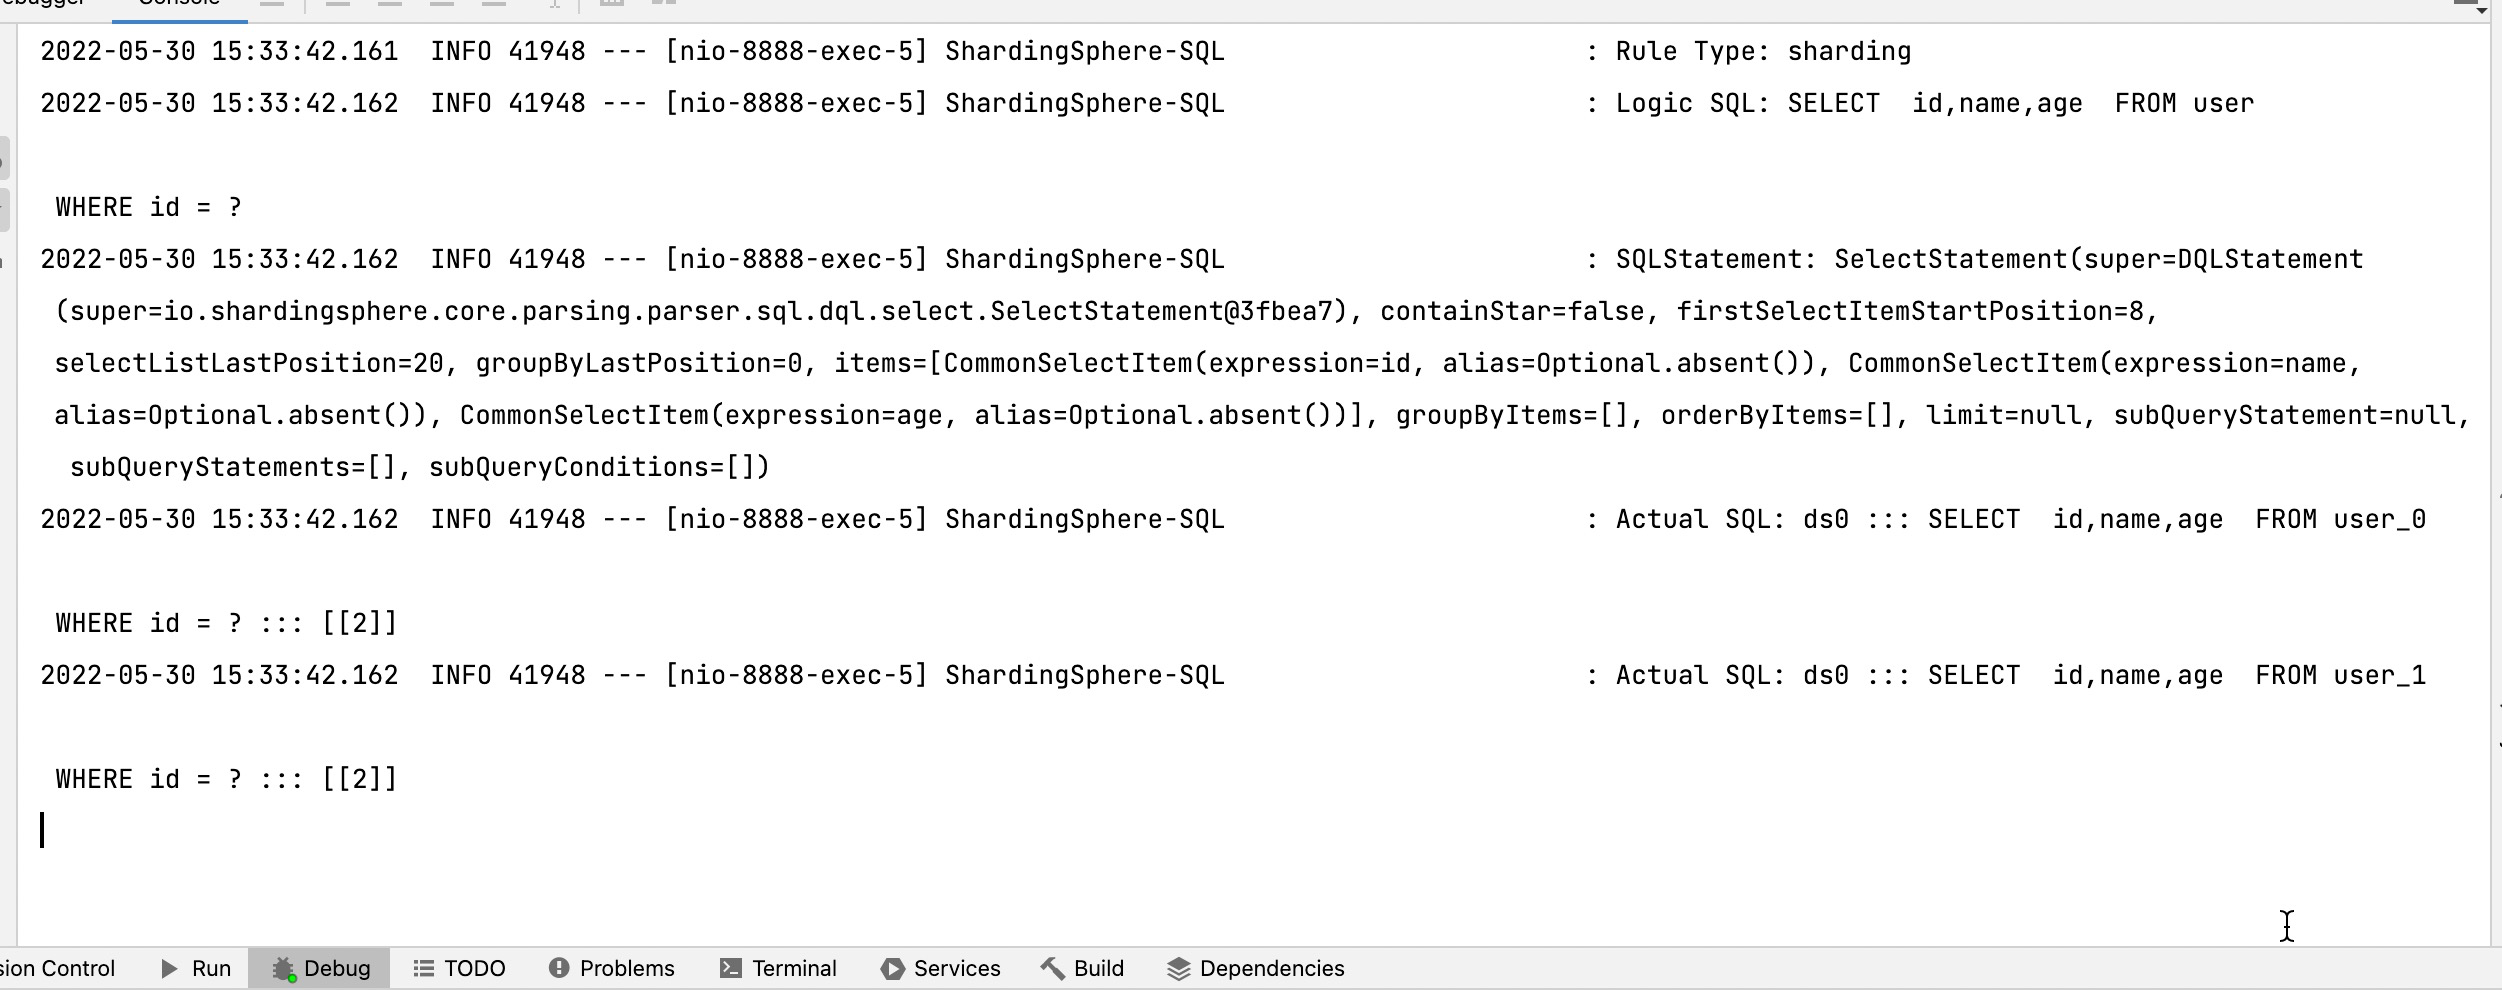
查询了当前id所在库的两个表
7.4携带分库分表参数
链接参数http://localhost:8888/select?id=2&age=27
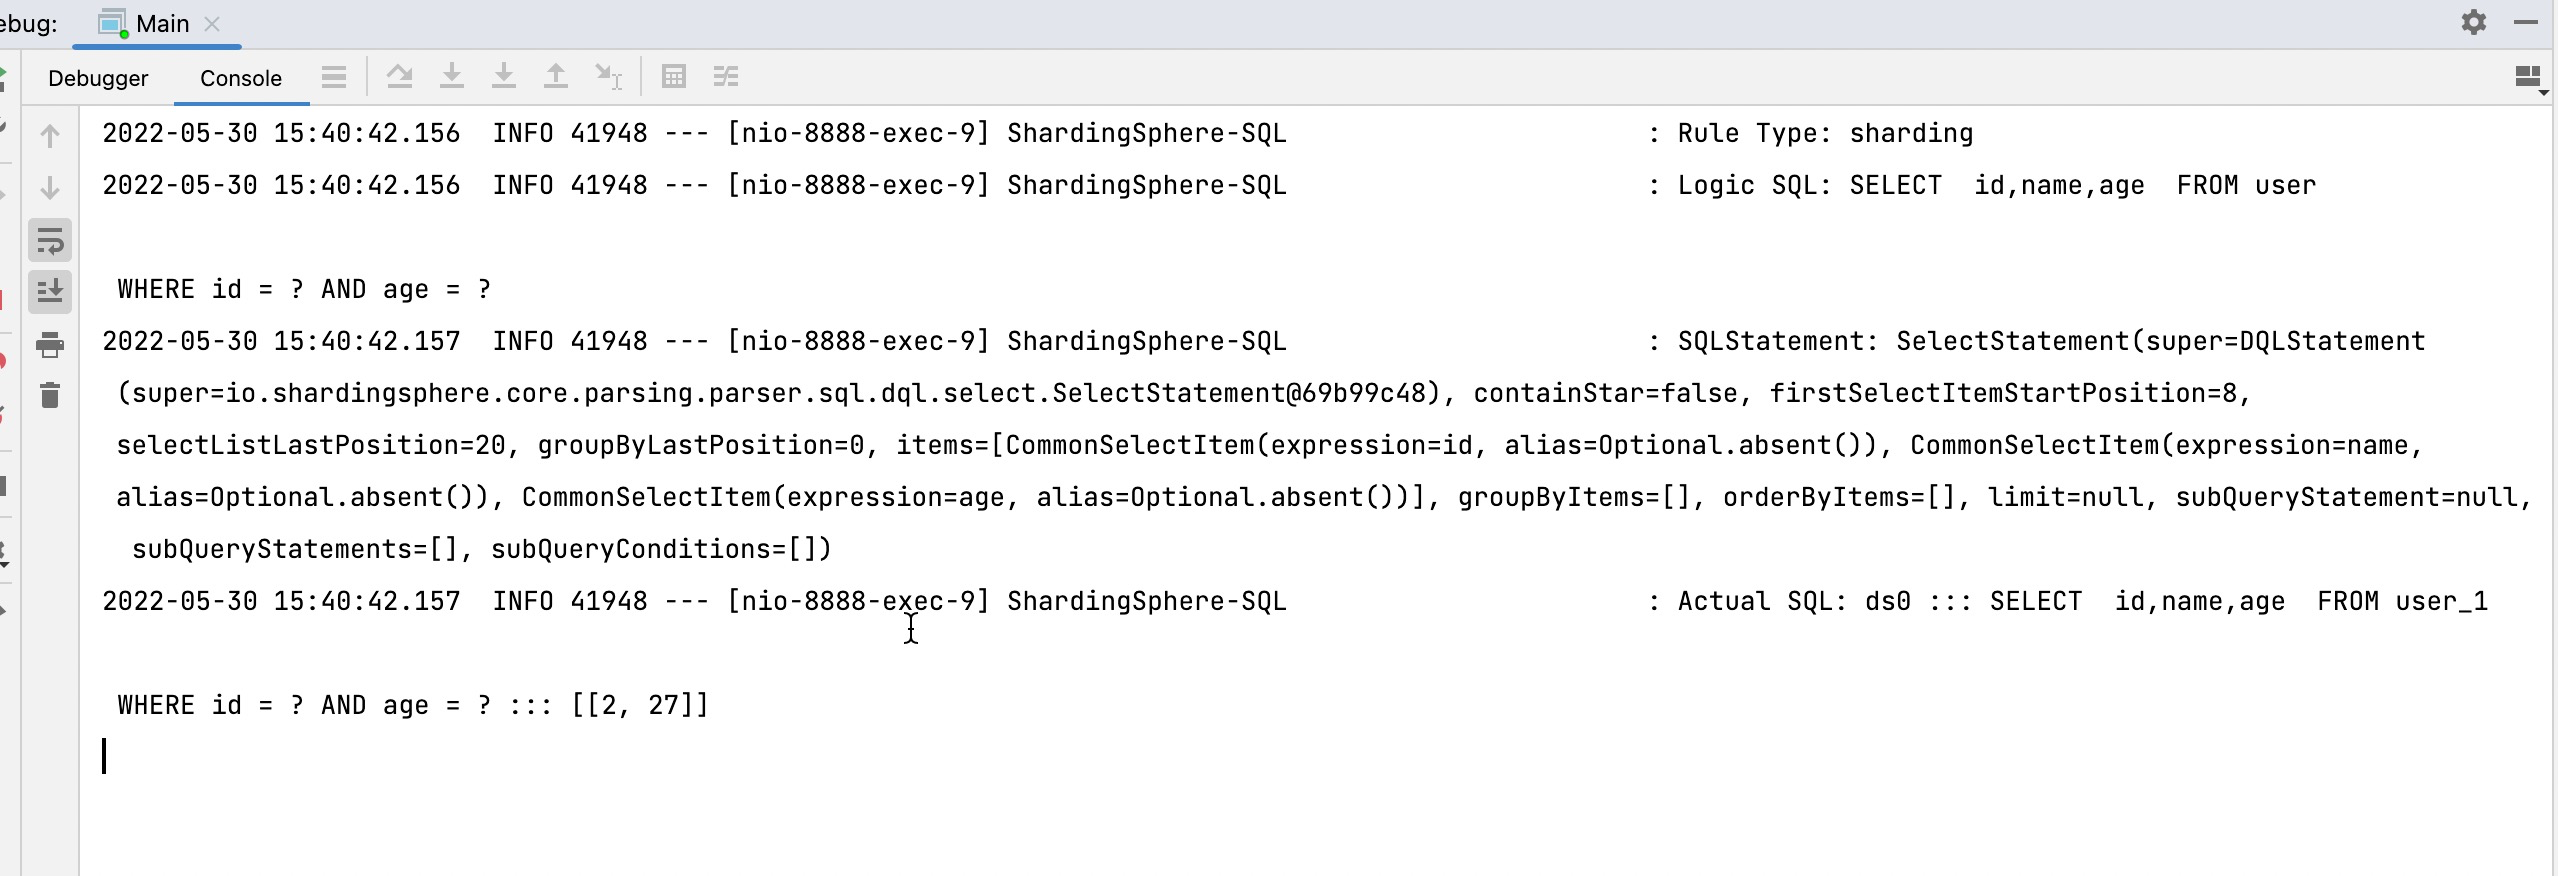
准确查询到了这条数据所在的库跟表
7.5分表分库查询原理
查询参数携带分库分表的索引时候,查询时候会计算精准命中我们要查的库表,没有携带则全表全库扫描,当数据量比较大的时候,效率会很差。数据库压力很大 。所以选取分库分表的索引应该要选择热点数据(字段)
8.分库分表带来的问题
8.1 跨库关联查询
比如查询在合同信息的时候要关联客户数据,由于是合同数据和客户数据是在不同的数据库,那么我们肯定不能直接使用 join 的这种方式去做关联查询。
我们有几种主要的解决方案:
字段冗余 比如我们查询合同库的合同表的时候需要关联客户库的客户表,我们可以直接把一些经常关联查询的客户字段放到合同表,通过这种方式避免跨库关联查询的问题。
数据同步 比如商户系统要查询产品系统的产品表,我们干脆在商户系统创建一张产品表,通过 ETL 或者其他方式定时同步产品数据。
8.2 分布式事务
比如在一个贷款的流程里面,合同系统登记了数据,放款系统也必须生成放款记录,如果两个动作不是同时成功或者同时失败,就会出现数据一致性的问题。如果在一个数据库里面,我们可以用本地事务来控制,但是在不同的数据库里面就不行了。所以分布式环境里面的事务,我们也需要通过一些方案来解决。
复习一下。分布式系统的基础是 CAP 理论。
C (一致性) Consistency:对某个指定的客户端来说,读操作能返回最新的写操作。对于数据分布在不同节点上的数据来说,如果在某个节点更新了数据,那么在其他节点如果都能读取到这个最新的数据,那么就称为强一致,如果有某个节点没有读取到,那就是分布式不一致。
A (可用性) Availability:非故障的节点在合理的时间内返回合理的响应(不是错误和超时的响应)。可用性的两个关键一个是合理的时间,一个是合理的响应。 合理的时间指的是请求不能无限被阻塞,应该在合理的时间给出返回。合理的响应,指的是系统应该明确返回结果并且结果是正确的。
P (分区容错性) Partition tolerance:当出现网络分区后,系统能够继续工作。打个比方,这里集群有多台机器,有台机器网络出现了问题,但是这个集群仍然可以正工作。
CAP 三者是不能共有的,只能同时满足其中两点。基于 AP,我们又有了 BASE 理论。
基本可用(Basically Available):分布式系统在出现故障时,允许损失部分可用功能,保证核心功能可用。
软状态(Soft state):允许系统中存在中间状态,这个状态不影响系统可用性,这里指的是 CAP 中的不一致。
最终一致(Eventually consistent):最终一致是指经过一段时间后,所有节点数据都将会达到一致。
分布式事务有几种常见的解决方案:
1、全局事务(比如 XA 两阶段提交;应用、事务管理器™、资源管理器(DB)), 例如Atomikos。 2、基于可靠消息服务的分布式事务。
3、柔性事务 TCC(Try-Confirm-Cancel)tcc-transaction
4、最大努力通知,通过消息中间件向其他系统发送消息(重复投递+定期校对)