ai工具的一些概念
把书籍跟互联网数据,当作自己的数据库,接受到用户提出的问题后,一直去预测下一个词,再去介入微调就成了我们使用的ai模型。
LLM
定义: Large Language Model (LLM),本质是基于概率的“文字接龙”。
架构: 基于 Transformer(2017年 Google 提出)。
Token
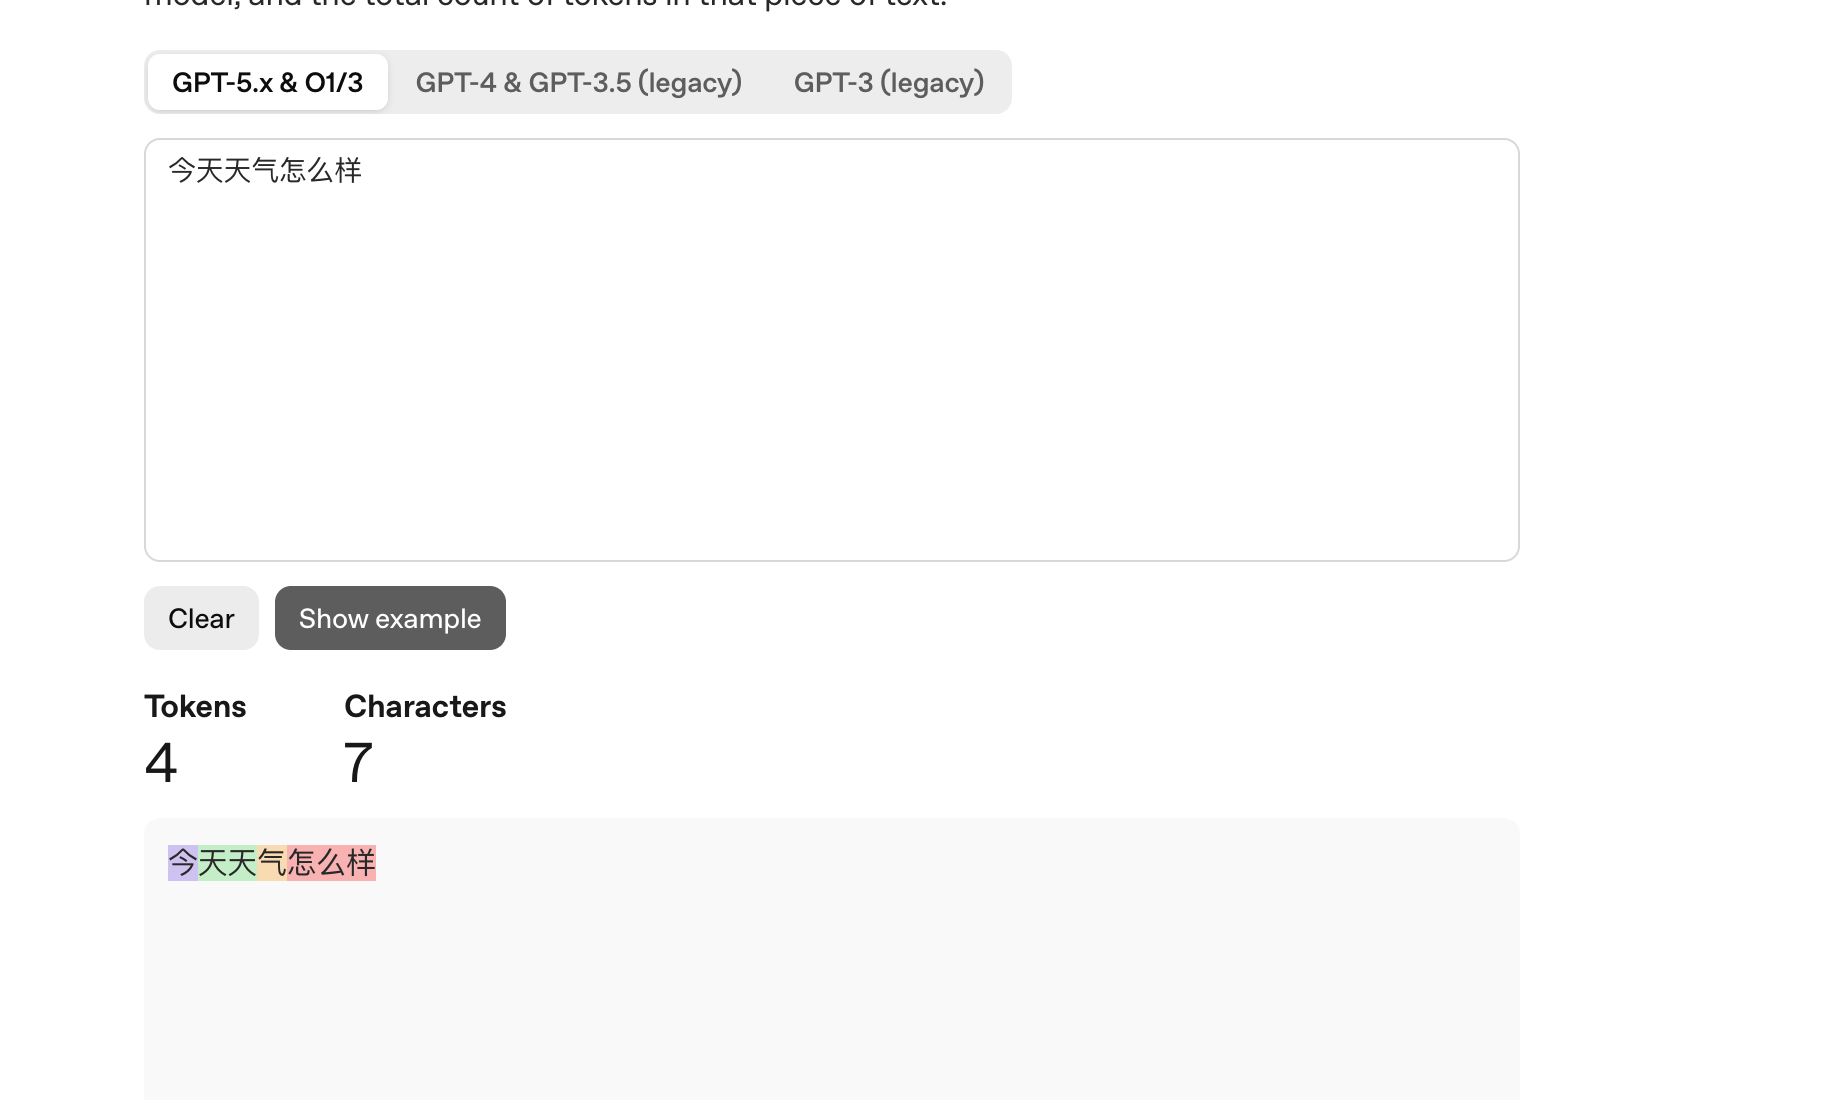
https://platform.openai.com/tokenizer openai提供的
token切割的网站
定义: 大模型处理文本的最小单位。通过 Tokenizer(分词器)将文本切分为片段。
编码过程: 分两步 —— ① 文本切分为 Token ② 映射为 Token ID(数字)。
解码过程: 将 Token ID 还原为文本(无需切分步骤)。
Token 与自然语言单位的关系
| 语言单位 | 与 Token 的关系 | 示例 |
|---|---|---|
| 中文词语 | 非一一对应,可能被拆分 | “程序员” $\rightarrow$ “程序” + “员” |
| 英文单词 | 常见词通常对应 1 个 Token | “hello” $\rightarrow$ 1 个 Token |
| 复杂单词 | 可能被拆分 | “helpful” $\rightarrow$ “help” + “ful” |
| 特殊字符 | 可能需多个 Token 表示 | “✅” $\rightarrow$ 3 个 Token |
过程:
-
用户提出问题,今天天气怎么样?
-
切分用户问题,切分4个
token -
持续输出
token直到结束符
Context
定义: 模型单次处理任务时接收的信息总和。
组成: 用户问题 + 对话历史 + 系统提示词 (System Prompt)。
限制: 受限于 Context Window(上下文窗口)。
扩展方案: RAG (检索增强生成)。通过从外部数据库检索相关片段,降低对原生窗口的依赖。
Prompt (提示词)
-
分类:
- User Prompt: 用户输入的内容。
- System Prompt: 设定模型的人设、规则、语气。
-
提示工程 (Prompt Engineering): 核心原则是 清晰、具体、明确。
Tool
核心作用
- 定义: 大模型调用的外部函数,使其能够感知和影响外部环境。
- 解决痛点: 弥补大模型无法获取实时信息(如天气)、计算能力有限等弱点
工作流程
- 用户提问 $\rightarrow$ 平台转发(含工具列表)
- 大模型分析 $\rightarrow$ 生成工具调用指令
- 平台执行调用 $\rightarrow$ 获取结果
- 大模型整理结果 $\rightarrow$ 自然语言输出
角色分工
- 大模型: 选择工具、生成参数、归纳结果。
- 工具: 执行具体功能(如查询天气)。
- 平台: 转发信息、执行工具调用。
MCP
- 全称: Model Context Protocol(模型上下文协议)。
- 本质: 理解为统一的工具接入标准,解决不同平台工具接入规范不统一的问题。
- 价值: 类似手机统一用 Type-C 接口。工具开发者只需按 MCP 规范开发一次,即可在所有支持 MCP 的平台使用。
Agent (智能体)
claude code / curos 都可以看作是一个Agent,本质就是模型规划
- Agent 定义: 能够自主规划、自主调用工具,持续工作直至完成用户任务的系统。
- 核心能力: 多步骤推理、工具选择、流程控制。
- 典型构建模式: ReAct (Reason + Act)、Plan and Execute。
Agent Skill
核心功能
- 定义: 给 Agent 的说明文档,包含任务规则、执行步骤、输出格式等。
- 结构:
- 元数据层: 名称 (name)、描述 (description)。
- 指令层: 目标、执行步骤、判断规则、输出格式、示例。
技术实现
- 存储形式: Markdown 文档(文件名必须为
SKILL.md)。 - 存放位置: 特定目录(如
.claude/skills文件夹)。
RAG
检索过程有点类似于es的倒排索引,本质就是把一段大的文本切割成很多小段,然后根据用户/检索的问题,去搜索对应的片段。可以节省token开支,也可以增加模型效率,跟上下文溢出的问题。
本质上是一个 ETL 过程:
- Load (加载): 读取 PDF、Word、数据库或 API 数据。
- Split (切片): 将长文档切成小块(Chunk),因为 LLM 的“内存”(上下文窗口)有限。
- Embed (向量化): 调用 Embedding 模型(如 OpenAI 的
text-embedding-3-small),将文字转为一串数字(向量)。 - Store (存储): 存入 向量数据库(Vector DB)。